GPUの正体とNVIDIAの特異性(なぜゲーム部品屋が世界を支配したのか?)
半導体の歴史において、これほど劇的で皮肉な逆転劇はありません。 わずか十数年前まで、コンピューティングの絶対王者は「CPU」を作るインテルでした。対するNVIDIAは、パソコンの中で「ゲームのグラフィックを綺麗に描画するための拡張部品(GPU)」を作るニッチな企業に過ぎませんでした。
しかし現在、AIデータセンターの予算の大部分はNVIDIAに吸い込まれ、世界で最も価値のある企業へと変貌を遂げています。 「なぜ、最強のCPUメーカーではなく、ゲームの部品屋が世界を支配できたのか?」
この問いの答えは、単純なチップの性能差ではありません。「演算の性質」の物理的なパラダイムシフトと、ハードウェアを売るために構築された**「不可侵のソフトウェア帝国(CUDA)」、そして単体のチップではなく「データセンター全体を1つの巨大なチップにする(NVLink)」**というボトルネック破壊の歴史にあります。
1. エリート5人 vs 1万人の単純労働者(CPUとGPUの物理構造)
コンピュータにおける「計算」は、大きく2つの性質に分かれます。 一つは「複雑な条件分岐」、もう一つは「膨大な単純計算」です。CPUとGPUは、シリコンという同じ素材で作られていながら、チップ内部の「面積の使い道」が根本的に異なります。
CPU:少数の超優秀なエリート
CPU(Central Processing Unit)の使命は、OSを動かし、データベースを管理し、ユーザーの予測不能な操作に遅延なく(低レイテンシで)応えることです。「もしAならばB、そうでなければC」といった複雑な条件分岐(If文)を瞬時に処理するため、チップ面積の大部分を**「次にどんな計算が来るかを予測する回路(分岐予測)」や「データをすぐ取り出せる巨大な本棚(大容量キャッシュメモリ)」に割いています。 実際に計算を行う「演算器(ALU)」は、全体のほんの一握りです。例えるなら、「どんな複雑な業務でも一瞬でこなすが、同時に数個のタスクしかできない5人の天才エリート」**です。
GPU:万の大軍勢による人海戦術
一方、ゲームのグラフィック描画(画面上の数百万ピクセルの色を同時に計算する)には、複雑な条件分岐は不要です。必要なのは「同じ足し算と掛け算を、何百万回も同時に行うこと」です。 そこでGPU(Graphics Processing Unit)は、複雑な制御回路や大容量のキャッシュを極限まで削ぎ落とし、空いた面積すべてに**「単純な演算器(ALU)」を詰め込みました。その数は最新のチップで数万個に及びます。これは「難しいことは分からないが、言われた単純作業を一斉にこなす1万人の労働部隊」**です。
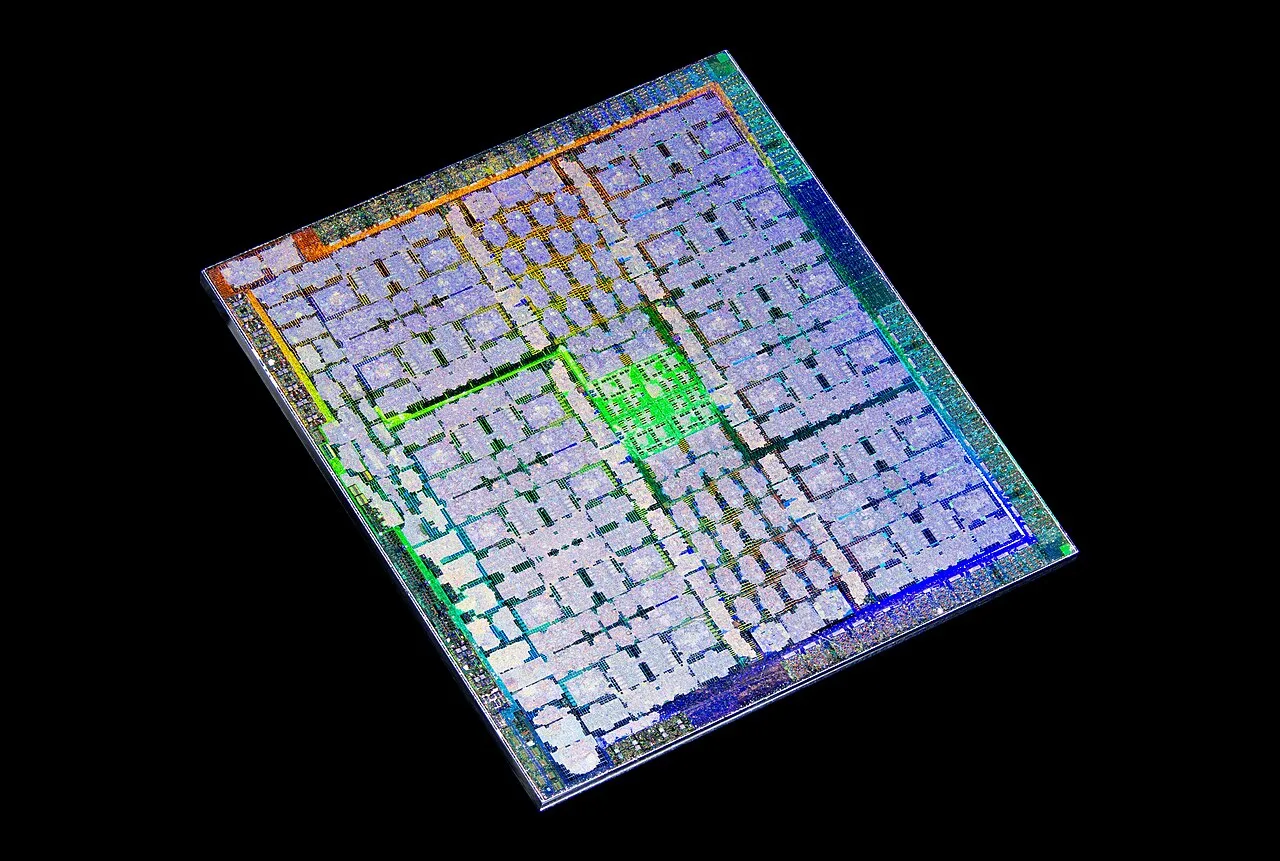
そして2012年以降、世界を揺るがした「ディープラーニング(深層学習)」の正体は、突き詰めれば**「数千億個の数字の行列に対する、ひたすら単純な掛け算と足し算の繰り返し」**でした。 AIの進化により、計算の主戦場が「複雑なロジック」から「単純な並列計算の暴力」へとシフトした瞬間、世界中の天才エリート(CPU)は、1万人の労働部隊(GPU)の圧倒的な物量(スループット)の前に敗れ去ったのです。
触って試す:並列度の体感シミュレータ
⚙️ 並列度の体感シミュレータ(単純演算 10,000 回)
AIの学習の正体は「同じ掛け算・足し算の繰り返し」。その仕事10,000回分を、働き手を変えて片付けると何ステップで終わるか比べてみましょう(1ステップ=全員が同時に1回ずつ計算する単位です)。
※ バーの長さは、桁の違いが分かるよう対数スケール(10倍ごとに同じ幅)で表示しています。
上のボタンから働き手を選んでください。
2. 狂気の投資「CUDA」が生み出した不可侵の帝国
しかし、「GPUが行列計算に強い」という物理的特性だけなら、インテルもAMDも強力なGPUを作ることができました。NVIDIAが独占的な覇権を握れた真の理由は、ハードウェアではなく**「ソフトウェアの堀(モート)」**にあります。
2006年、NVIDIAのCEOジェンスン・フアンは「CUDA(Compute Unified Device Architecture)」という開発プラットフォームを発表します。 当時のGPUは、グラフィックを描画するための専用言語(シェーダー)でしか動かせませんでした。CUDAは、一般的なプログラマーが慣れ親しんだ「C言語」などで、GPUの万の大軍勢を自由に操れるようにしたのです。
「世界中の研究者が、GPUを汎用的なスーパーコンピュータとして使えるようにする」
この構想のため、NVIDIAは自社のすべてのGPUにCUDA用の回路を組み込み、巨額の利益をソフトウェア開発に注ぎ込みました。当時のウォール街からは「ゲーム機のための部品屋が、無駄な研究開発で利益を削っている」と激しく非難されました。 しかし、この15年以上にわたる「狂気の投資」が、NVIDIAをAIの「Windows」へと変えました。
AI研究者が新しい論文を書くとき、AIエンジニアがPyTorchなどのフレームワークを動かすとき、その足回りには必ずCUDAが前提として敷かれています。競合他社がいくら安くて速いAIチップを作っても、「CUDAで書かれた世界中のAIプログラムが動かない」という絶対的なソフトウェアの障壁の前に、手も足も出ない状態が続いているのです。
3. PCIeの限界と「NVLink」によるボトルネック破壊
さらにNVIDIAは、物理的な「データの移動」という最大のボトルネックを破壊しました。 ChatGPTのような巨大なLLM(大規模言語モデル)は、数百GBの容量があり、1枚のGPUのメモリ(最大でも80GB〜192GB)には到底収まりません。必然的に、数千枚のGPUを繋げて「1つの巨大な脳」として計算させる必要があります。
ここで問題になるのが、マザーボード上の標準規格である**「PCIe(PCI Express)バス」です。 通常、GPU同士がデータをやり取りする場合、一度CPUを経由し、PCIeという「細い一般道」を通らなければなりません。どんなにGPUの演算が速くても、データの受け渡しに時間がかかれば、万の軍勢はヒマを持て余してしまいます(これがI/Oボトルネック**です)。
そこでNVIDIAは、業界標準のPCIe規格を無視し、GPU同士を直接結ぶ極太の専用バイパス**「NVLink」と、サーバーラック内の全GPUを遅延なく直結する「NVSwitch」**を自社で開発しました。
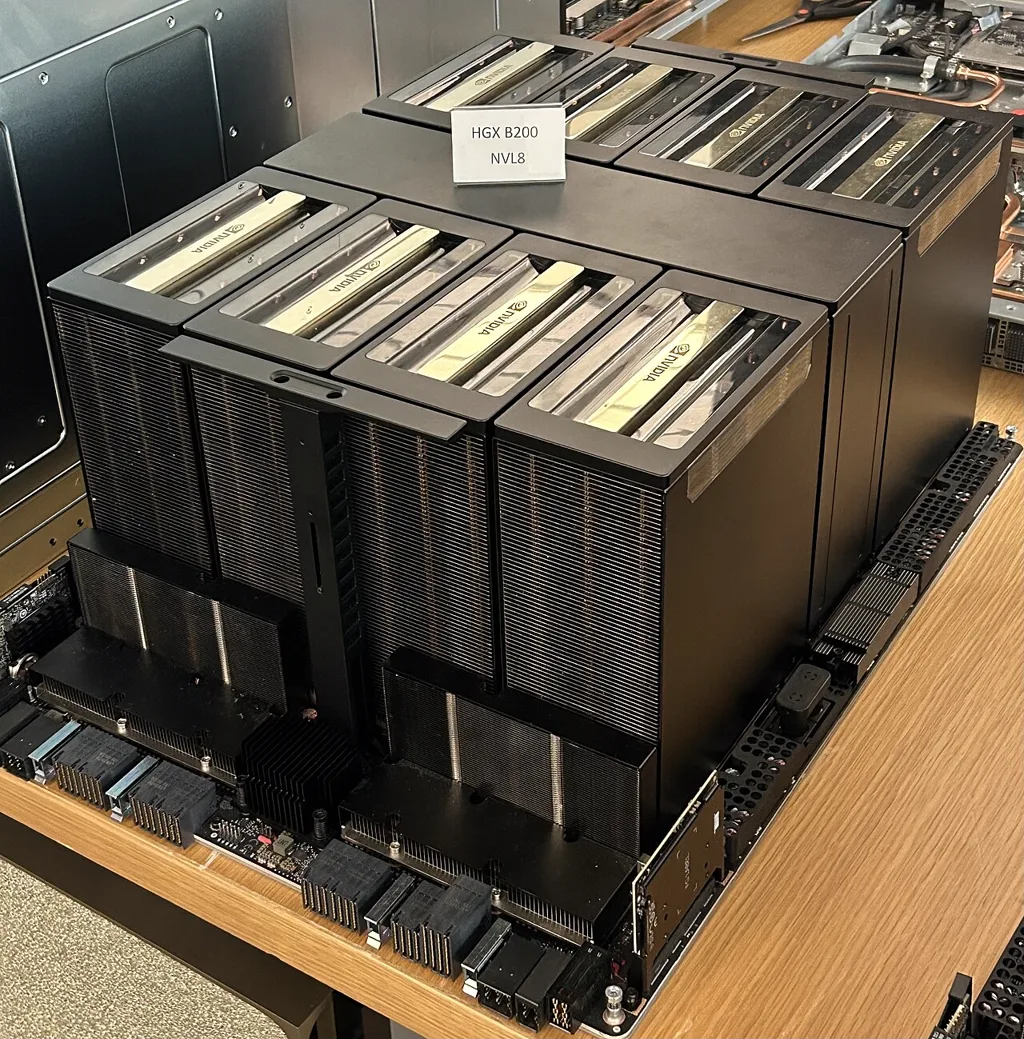
最新のNVLinkは、PCIeの数倍から十数倍という桁違いの帯域幅(通信の太さ)を持ちます。これにより、ラックに収められた数十台のGPUは、物理的には別々のチップでありながら、まるで**「1つの巨大なGPU」であるかのように振る舞うことができます。 NVIDIAは今や「チップ」を売っているのではなく、ラック全体、ひいては「データセンターという巨大なコンピュータそのもの」**を丸ごと設計し、販売しているのです。
結論:計算の覇権は「データの移動」を制する者へ
インテルが「いかに1つの脳を速くするか」にこだわっていた間、NVIDIAは「いかに万の軍勢に指示を出し(CUDA)、いかに彼らの間の連絡網を太くするか(NVLink)」に全力を注ぎました。
AIの進化が止まらない限り、計算の速さとはもはや「演算器の速さ」ではありません。膨大なデータをどうやって滞りなく移動させるかという**「通信と物理配線の勝負」**へと、戦いのルールは完全に書き換わったのです。
📝 3行で頭に入る『試験・実務・投資の要点まとめ』
- 【構造の物理】 CPUは複雑な条件分岐をこなす「少数のエリート」、GPUは単純な並列計算を圧倒的な物量でこなす「万の労働部隊」。AIの行列計算にGPUが合致した。
- 【ソフトウェアの堀】 NVIDIAの真の強みはチップ単体ではなく、15年以上前から巨額の投資で築き上げた開発環境「CUDA」。これがAI開発の実質的な世界標準(OS)となっている。
- 【インフラ設計】 巨大なAIを動かすには複数GPUの連携が必須。NVIDIAは汎用規格(PCIe)の遅さを嫌い、専用線「NVLink」を構築することで、データセンター全体を1つの巨大なチップに昇華させた。