スーパーコンピュータ「富岳」とは何か?――普通のパソコンを10万台並べても絶対に勝てない「物理の壁」
1. 素朴な疑問:最新パソコンを10万台並べても「富岳」になれない理由
「最新の高性能ノートパソコンやサーバーをAmazonで10万台買い、家庭用ルーターとLANケーブルで繋げば、スーパーコンピュータを作れるのではないか?」
技術の勉強を始めたばかりのエンジニアなら、一度は思い浮かべる疑問です。現在のPCに積まれているCPUは非常に優秀で、1台でも毎秒数千億回もの計算をこなします。10万台集めれば、単純計算で凄まじい計算パワーが生まれるはずです。
しかし、結論から言うと、そのシステムで「富岳(ふがく)」と同じ計算をさせても、性能は1%も出ずに破綻します。
なぜでしょうか。理由は「計算機の頭脳が遅いから」ではありません。**「10万台をつなぐネットワークとメモリの受け渡しが、物理的に遅すぎるから」**です。
「バラバラに解ける問題」と「全員で解く問題」の決定的な違い
世の中の計算には、大きく分けて2つの種類があります。
- 疎結合(そけつごう)な問題: 「100万枚の写真に写っている猫を一斉に探す」ような計算です。PC Aが1枚目を調べ、PC Bが2枚目を調べればよく、PC同士が途中で会話する必要はありません。これなら、世界中の家庭用PCをネットで繋いだ「分散コンピューティング」で十分対応できます。
- 密結合(みつけつごう)な問題: 「明日の線状降水帯の発生を予測する」「ウイルスの飛沫が空気中でどう広がるかシミュレーションする」ような計算です。空間をミリ単位の立方体に区切り、それぞれの空気の圧力や温度を計算します。隣の立方体の空気が動けば、次の瞬間には自分の立方体の温度が変わるため、10万台のコンピュータが1秒間に何千回も「いま計算した結果」を全員で突き合わせなければなりません。
ここで巨大な壁となって立ちはだかるのが、**「アムダールの法則」と「光の速度」**です。
どれほど計算部が高速でも、全体の計算時間は「最も遅い通信待ち」に引っ張られます。10万台のうち1台でもデータ待ちで止まれば、残り9万9,999台も腕を組んで待機するしかありません。
一般のPCをLANケーブルで繋ぐと、通信の往復に数マイクロ秒から数ミリ秒かかります。計算が0.000001秒で終わっても、通信に0.001秒かかっていれば、コンピュータは全稼働時間の99.9%を「ただの待ち時間」として浪費します。
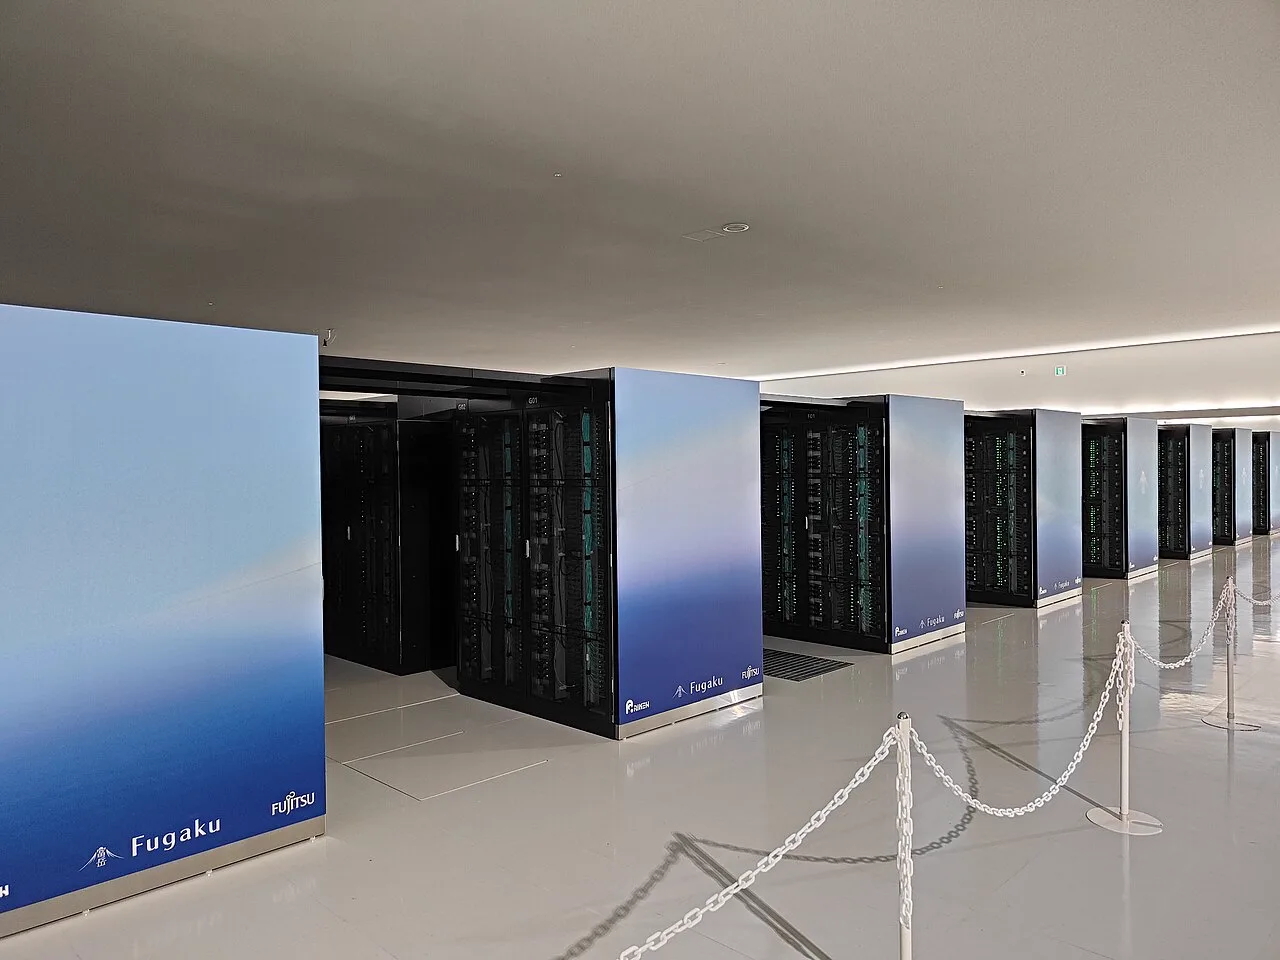
理化学研究所に鎮座する「富岳」は、この「待ち時間」を極限までゼロに削り取るために、物理学と半導体工学の限界を突破した超高密度マシンなのです。

2. 光速の限界に挑む:超低遅延「Tofu(豆腐)インターコネクトD」
コンピュータの世界では、電気信号や光信号の速度は「無限」ではありません。真空中での光の速度は秒速約30万キロメートルですが、銅線や光ファイバーの中を通る電気や光は、物質の抵抗や屈折率によって減速し、**「秒速約20万キロメートル」**まで落ちます。
これは言い換えると、**「信号がわずか20センチメートル進むだけで、丸々1ナノ秒(10億分の1秒)が消費される」**ということです。
【信号の物理伝播速度】
1ナノ秒(0.000000001秒) = 光ファイバー中を約20cmしか進めない
3GHzで動く最新CPUは、0.33ナノ秒に1回クロックを刻みます。CPUが3回息を吸って吐く間に、電気信号は机の端から端へすら届きません。10万台のPCを広い部屋に並べて長いLANケーブルで配線した時点で、「光の遅さ」によってスーパーコンピュータ失格となるのです。
触って試す:光の速さ計算機
💡 光の速さ計算機(信号は1ナノ秒で20cmしか進めない)
距離のボタンを押すと、信号が片道で届くまでの伝播時間と、その間に3GHzのCPUが刻むクロック数を表示します。
距離を選んでください。
ネットワークカードを捨て、CPUの中に直結回路を埋め込む
富岳には、合計158,976個の独自開発CPU「A64FX」が搭載されています。この天文学的な数のノードを繋ぐために開発されたのが、日本独自の**「Tofu(豆腐)インターコネクトD」**と呼ばれる超高速ネットワークです。
一般的なサーバーは、通信する際にOS(Linuxカーネル)を呼び出し、PCIeスロットに刺さったLANカードを経由します。この「OSのお伺いを立てる処理」だけで数マイクロ秒が消し飛びます。
富岳は、この無駄を徹底的に排除しました。
- 通信機能をCPU内部に一体化: 通信制御チップを別付けするのではなく、A64FXプロセッサのシリコンダイの中にTofuのコントローラを最初から焼き込みました。
- OSを無視して相手のメモリを直撃(RDMA:Remote Direct Memory Access): あるCPUが、別の棚にあるCPUのメモリに対して、相手のOSを起こすことなく直接データを書き込み・読み出しします。
- 6次元メッシュ・トーラス構造: ノード同士を前後・左右・上下の3次元だけでなく、数学的な「6次元」の格子状に網の目配線しています。これにより、隣のノードへの遅延は0.5マイクロ秒(100万分の0.5秒)未満に抑えられ、どこかの配線が故障しても瞬時に迂回路を見つけてデータの渋滞を回避します。
名前の「Tofu」は、ノードの塊(トポロジー)を豆腐の角切りに見立てたことに由来しますが、その実態は「光速の物理限界」に極限まで抗うための冷徹な超低遅延ハードウェアです。

3. 計算機を飢餓から救う:メモリバンド幅1TB/sと「HBM2」の衝撃
どれほどCPUの計算速度を上げても、現場のプログラマーを絶望させるもう一つの物理的制約があります。それが**「フォン・ノイマン・ボトルネック(メモリの壁)」**です。
CPUの計算コアがどれほど速くても、計算する材料(データ)がメモリから届かなければ、CPUは手を止めて立ち尽くします。これを専門用語で**「CPUの飢餓(Starvation)」**と呼びます。
なぜ市販のDDRメモリでは駄目なのか?
通常のパソコンは、マザーボードのスロットに板状のメモリ(DDR4やDDR5)を挿します。この構造では、CPUとメモリの間をマザーボード上のプリント配線(銅線)で繋ぐしかありません。
配線を増やせばマザーボードが巨大化し、周波数を上げすぎればノイズ(電磁干渉)が発生して信号が壊れます。そのため、最新のPCでもメモリからCPUへ送れるデータ転送速度(バンド幅)は、せいぜい毎秒数十GB〜100GB前後が限界です。
これに対して、富岳のCPU「A64FX」は、**毎秒1,024GB(1TB/s超)**という規格外のメモリバンド幅を誇ります。一般的なPCの10倍〜20倍以上の猛スピードで、ドラム缶から水を流し込むようにデータをCPUへ注ぎ込みます。
これを実現したのが、**「HBM2(High Bandwidth Memory 2)」**と呼ばれる立体積層メモリです。
| 項目 | 一般的なハイエンドサーバー (DDR5) | 富岳のプロセッサ A64FX (HBM2) |
|---|---|---|
| メモリの配置場所 | マザーボード上の別スロット | CPUパッケージの基板上(数ミリ至近距離) |
| 接続技術 | 基板上の配線パターン | シリコン貫通電極(TSV)による垂直積層 |
| メモリバス幅 | 64〜128 bit | 4,096 bit(超極太配線) |
| 転送帯域幅 | 約50〜100 GB/s | 1,024 GB/s(約1TB/s) |
| 得意な処理 | 単一タスクの処理 | 大規模シミュレーションの連続並列処理 |
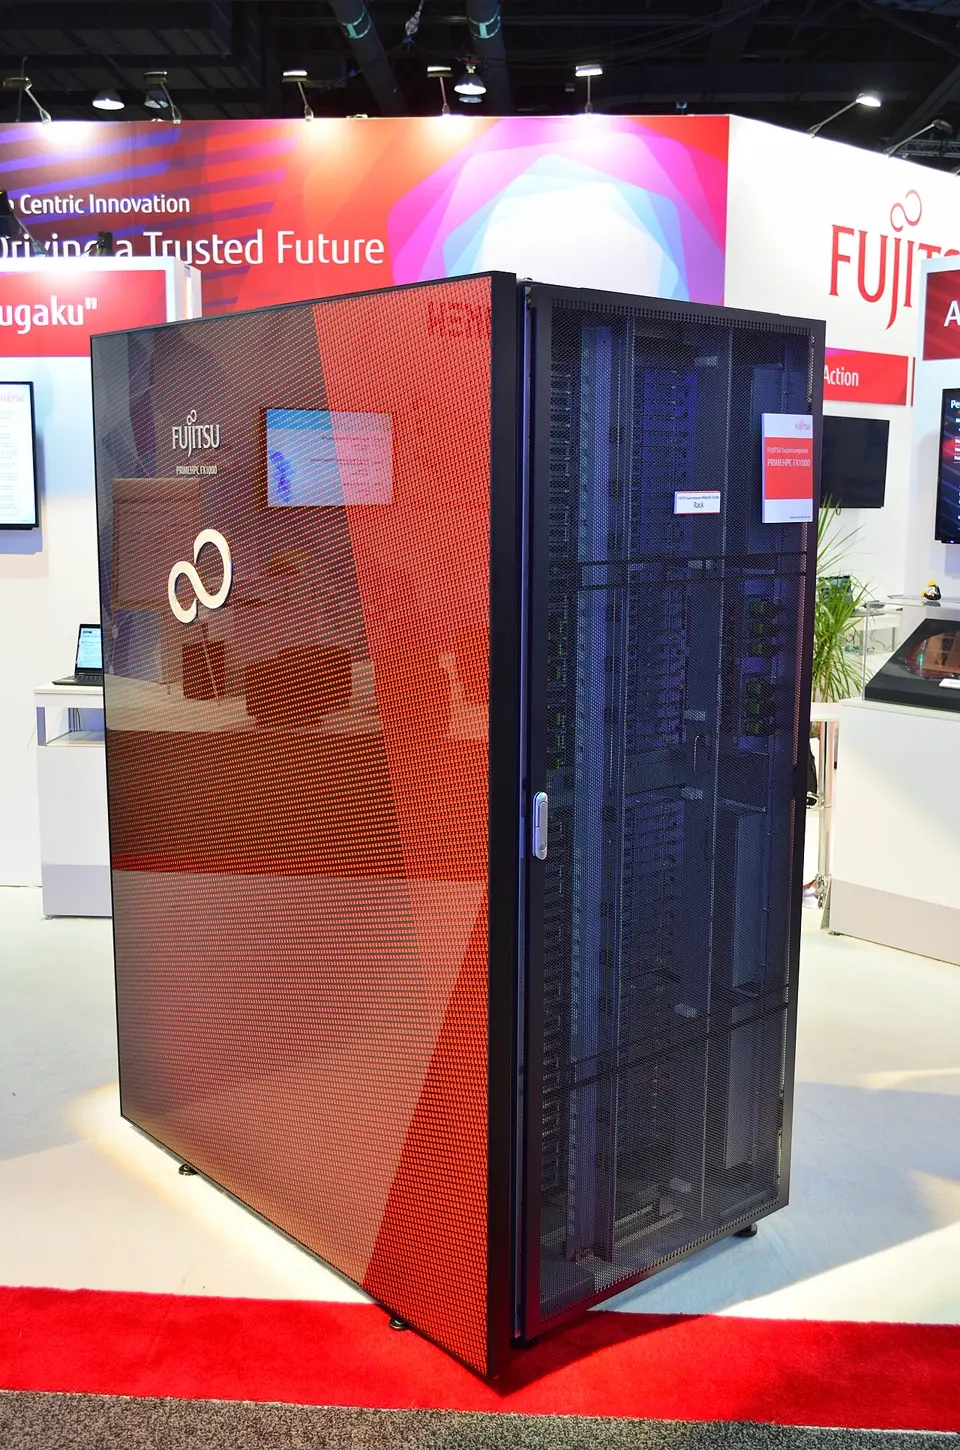
富岳のCPUパッケージを開けると、中央にあるCPUコアのすぐ真横に、薄い長方形のシリコンダイが4個並んで鎮座しています。メモリチップに無数の目に見えない微細な穴を開け、垂直に積み重ねて超至近距離で繋ぐことで、ノイズを出さずに4,096本もの信号線を一気に通すことに成功したのです。
富岳はカタログ上の最大理論性能だけでなく、「実際のシミュレーションプログラムを走らせたときの実効性能」で世界一を取り続けました。その最大の秘密は、この**「計算コアを絶対に遊ばせないメモリの超太い帯域」**にあります。
4. 物理の最終関門:空冷の限界と「30℃の温水」で冷やす熱工学
15万8,976個の超高性能CPUを1つの建物に密集させて一斉にフル稼働させると、巨大な物理的副産物が生まれます。**「猛烈な熱」**です。
富岳が消費する電力は、全力稼働時でおよそ15〜20メガワット(MW)。これは、一般的な家庭数万世帯が消費する電力を1フロアに集中させているのに等しく、そのエネルギーのほぼ100%がそのまま熱に変わります。
もし富岳をファンによる「空気(空冷)」で冷やそうとすれば、何が起きるでしょうか。
空気は熱を運ぶ能力が低すぎる
高校物理で習う通り、物質には「比熱(熱の温まりにくさ・熱の運びやすさ)」があります。水の比熱は約4.2 J/(g・K)であるのに対し、空気の比熱は約1.0 J/(g・K)しかありません。さらに空気はスカスカ(密度が低い)なため、同じ体積で比べると、水は空気の3,000倍以上の熱を吸収して持ち去ることができます。
空冷で20メガワットの熱を奪おうとすれば、部屋の中に暴風雨のような巨大ハリケーンを吹き荒れさせる必要があり、ファンを回すためだけにさらに数メガワットの電力が消えてしまいます。
そこで富岳が採用したのが、**「ダイレクト水冷(完全直接液冷工学)」**です。
- CPUに銅製水冷ジャケットを直付け: 冷風を吹き付けるのではなく、CPUダイの真上に極小の流路を刻んだ金属製冷却プレートを押し当て、そこへ直に冷却水を流し込みます。
- 冷水ではなく「約30℃の温水」で冷やす妙技: ここが熱工学の最も興味深い点です。「よく冷えるなら、5℃の氷水を流せばいい」と思いがちですが、それをやると部屋の湿気が配管の表面に触れて**結露(水滴)を起こし、精密半導体がショートして爆発します。 さらに、水を5℃まで冷やすには巨大な冷蔵庫(チラー)をフル回転させる必要があり、莫大な電気代がかかります。富岳は、外気ファンで冷やしただけの「約30℃のぬるい水」**を送り込みます。CPUの温度(70℃〜80℃)よりも十分に低いため、30℃の水でもグングン熱を奪うことができ、結露も一切起きません。
熱を奪って温まった水は建物の屋外冷却塔に送られ、外気へ熱を逃がしたあと、再び富岳のラックへと循環していきます。この徹底した省エネ設計により、富岳は省エネ性能ランキング(Green500)でも世界トップクラスの評価を獲得しました。
5. まとめ:富岳とは「物理法則との調停装置」である
スーパーコンピュータ「富岳」の正体を一言で表すなら、**「15万台のCPUを、光速と熱の限界をねじ伏せて、1台の巨大なチップとして同期させる物理装置」**です。
市販のPCを何万台並べても勝てない理由は、CPUの性能差ではありません。
- 光の速度による遅延(通信の壁)
- 細い配線によるメモリ供給の遅さ(メモリバンド幅の壁)
- 猛烈な排熱の処理(熱力学の壁)
この3つの物理的限界に対して、**「TofuインターコネクトD」「HBM2立体積層メモリ」「完全直接水冷工学」**という半導体・ネットワーク・機械工学の粋を結集して立ち向かったからこそ、富岳は単なる「計算機の寄せ集め」を超えて、世界の頂点に立つことができたのです。
私たちが普段書いているWebアプリケーションやクラウドの背後にも、規模は違えど全く同じ「ネットワーク遅延」「メモリ帯域」「熱問題」の法則が横たわっています。巨人の構造を知ることは、日常のアーキテクチャ設計を根本から見つめ直す最高の教科書なのです。
📝 3行で頭に入る『試験・実務の要点まとめ』
- 密結合並列の壁: 単にPCを並べただけでは通信遅延(ミリ秒)がボトルネックになり破綻する。富岳はTofu-DでOSを介さずナノ秒台で全ノードを直結した。
- B/F比(メモリ帯域): CPUの処理能力に対してメモリ転送が遅いと計算コアが飢餓を起こす。富岳は立体積層メモリ「HBM2」をCPUダイに直結し、1TB/s超の超広帯域を実現した。
- 熱工学の解: 20MWに及ぶ発熱は比熱の小さい空気では運べない。結露を防ぎつつ省エネを実現するため、「約30℃の温水」をCPU直上の水冷ジャケットに直接循環させている。