HBM(広帯域メモリ)と「メモリの壁」の物理
最新のAIアクセラレータ(NVIDIAのH100やB200など)の基板写真や模式図を見ると、誰しも奇妙な違和感を覚えます。
一般的なパソコンであれば、マザーボード上のスロットに細長い板状のメモリ(DRAMスティック)をパチンと挿すのが当たり前でした。CPUとメモリは、数センチから十数センチ離れた場所に誇らしげに並んでいます。 しかし、AIデータセンターの主役であるチップの真ん中には巨大なGPUダイ(シリコン片)が鎮座し、そのミリ単位の至近距離を、小さな黒い四角い塊がギチギチに取り囲んでいます。しかもその小さな四角形の中身は、極薄に削られたメモリチップがマンションのように何重にも垂直に積み上げられています。
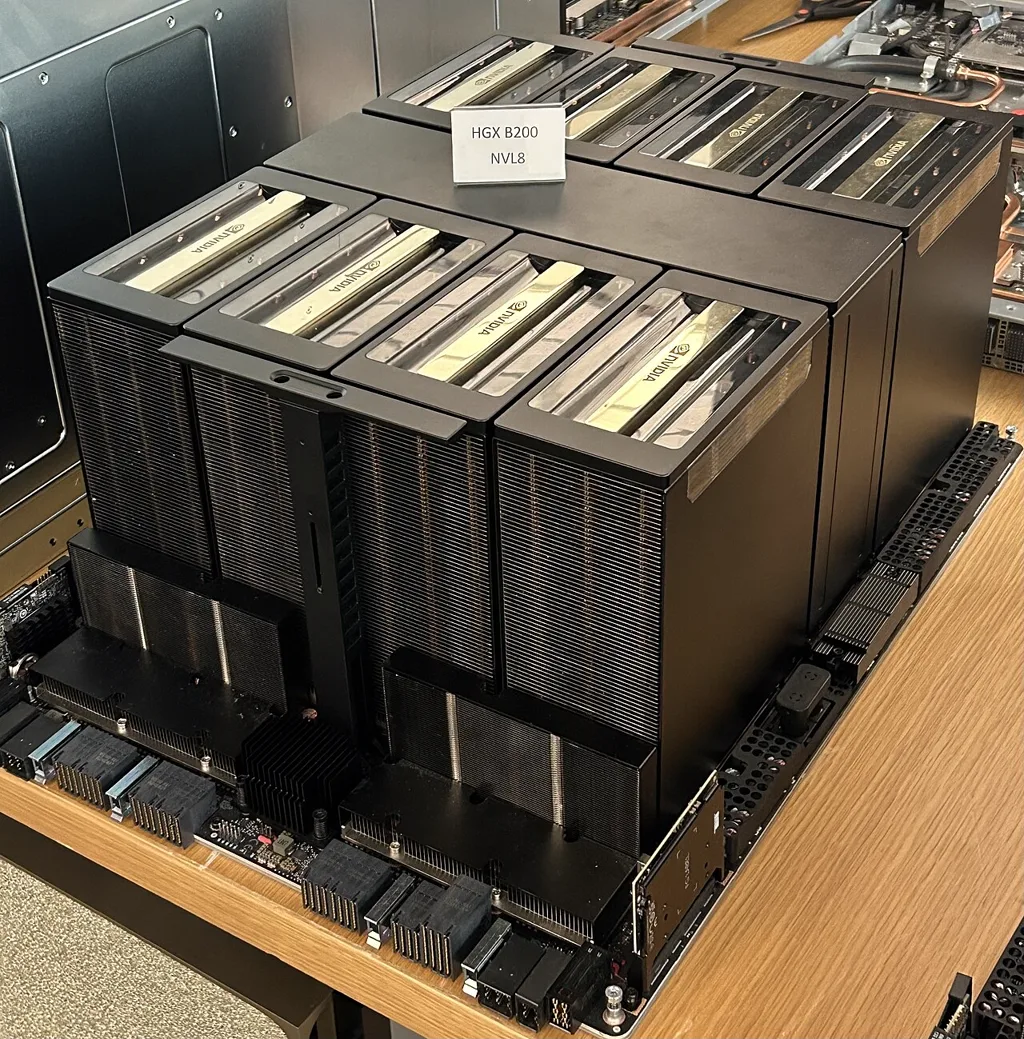
これが、現代のAIハードウェアの命運と価格を決定づけている**「HBM(High Bandwidth Memory:広帯域メモリ)」**です。
なぜ、わざわざそんな製造難易度もコストも桁外れに高い構造にする必要があるのでしょうか? そこには、コンピュータが40年以上にわたって直面し続け、AIの登場によって完全に衝突してしまった**「メモリの壁(Memory Wall)」という物理の限界**がありました。
1. 「メモリの壁」という物理の限界(食べる速度 vs 運ぶ速度)
コンピュータの性能を考えるとき、多くの人は「プロセッサが1秒間に何回計算できるか(FLOPS)」ばかりに目を奪われます。しかし、どれほど計算が速いプロセッサであっても、**「計算すべきデータが届かなければ、腕組みをして待つしかない」**という絶対的な制約があります。
プロセッサの演算能力(ALUの動作速度と並列数)は、過去40年間のムーアの法則に従って数万倍〜数十万倍という爆発的な進化を遂げました。 一方で、データを保管するDRAM(メインメモリ)のアクセス速度(レイテンシや帯域幅)は、せいぜい数十倍から百倍程度しか向上していません。
この結果生じたのが「メモリの壁」です。 例えるなら、**「1秒間に1万杯のラーメンを完食できる胃袋(GPU)」の前に、「小さなスプーンで1杯ずつ運んでくる給食係(従来のDDRメモリ)」**がついている状態です。プロセッサは計算時間の99%を「メモリからデータが届くのを待つ無駄な時間(アイドリング)」に費やすことになります。
AI(Transformer)がメモリを干からびさせる理由
特にChatGPTなどのLLM(大規模言語モデル)の推論処理では、この問題が致命的に現れます。 LLMの推論は「1トークン(文字)を生成するたびに、モデルの全パラメータ(数百億〜数千億個の重みデータ)をメモリからプロセッサへ丸ごと読み出す」という処理を繰り返します。
計算自体の複雑さよりも、**「どれだけ大量のデータを、一瞬でプロセッサの胃袋に流し込めるか(メモリ帯域幅:GB/s)」がトークンの出力速度を100%決定づけます。これを専門用語で「メモリ帯域律速(Memory Bandwidth Bound)」**と呼びます。 計算機をいくら速くしても意味がない。データを運ぶ配線のボトルネックを物理的に破壊しない限り、AIはこれ以上1歩も速くなれない領域に達したのです。
2. DDR vs HBM:速度制限を上げるか、車線数を狂気的に増やすか
では、メモリからデータを運ぶスループット(帯域幅)はどうやって決まるのでしょうか? 数式は極めて単純です。
$$ \text{帯域幅 (Byte/s)} = \text{バス幅 (bit:配線の数)} \times \text{転送レート (Hz:1秒間の信号回数)} \div 8 $$
つまり、データを速く送る方法は2つしかありません。
- 周波数(クロック)を上げて、信号を猛スピードで走らせる
- バス幅(配線の本数)を増やして、同時に運べる数を増やす
従来のDDR/GDDRのアプローチ:時速300kmのスポーツカー
パソコンのDDR5や、従来のグラフィックボードで使われるGDDRメモリは、主に「1(周波数を上げる)」を追求してきました。 マザーボードや基板の上には、他の部品や配線が密集しています。配線の本数を何千本も引き回すと、配線同士が電磁気的に干渉(クロストークノイズ)し、信号がグチャグチャに壊れてしまいます。そのため、配線数(バス幅)は**32bit〜64bit(GDDRでも384bit程度)**と極めて少数に抑え、その代わりギガヘルツ(GHz)クラスの超高速信号でデータをピストン輸送しました。
しかし、電気信号を高周波にすると、物理的な限界にぶつかります。
- 発熱の急増:周波数を上げると、消費電力と発熱は二乗に比例して跳ね上がる。
- 高周波の減衰:電気信号は周波数が高くなるほど、導体の表面しか流れなくなる(表皮効果)ほか、基板材料にエネルギーを奪われて波形がなまってしまう。
基板の上を数センチメートル走らせる従来の配線技術では、これ以上周波数を上げて帯域を伸ばすことは限界に達していました。
HBMのアプローチ:時速60kmのトラックが1024台並走する超巨大道路
そこで登場したHBMの思想は、真逆でした。 「周波数を無理に引き上げるのはやめよう。その代わり、配線の本数を数千本に増やせばいい」
HBMは、1つのスタック(塊)だけで**「1024bit(1024本)」ものデータ信号線を持ちます。最新のGPUではこのHBMを6〜8個並列に並べるため、バス幅は6144bit〜8192bit**という天文学的な数に達します。 普通のメモリが「時速300kmで爆走する1車線のスポーツカー」だとすれば、HBMは「時速60kmで安全運転するトラックが、1024車線の超巨大ハイウェイを一斉に並走している」状態です。
結果として、最新の「HBM3e」では、1つのGPUに対して**秒間8テラバイト(8 TB/s)**を超えるという、DDR5メモリ(数十GB/s)の100倍以上のデータを津波のように流し込むことが可能になりました。
触って試す:帯域の体感計算機
⏱️ 帯域の体感計算機
LLMの推論では、1トークンを出すたびにモデルの重み全体をメモリから読み直します。モデルの大きさとメモリの種類を選ぶと、重みを1回運び切る時間(=1トークンの生成時間の下限)が分かります。
モデルの大きさ(重みの容量)
メモリの種類
※ 帯域は記事の記述に基づく値(DDR5は「数十GB/s」の代表値として80GB/s、GDDRは384bitバスのGDDR6X級として約1TB/s、HBM3eは記事の8TB/s)。重みの容量はパラメータ数×2バイト(FP16)の目安。帯域バーは対数スケールです。
3. 縦に穴を開けて貫通させる「TSV(シリコン貫通電極)」の力学
問題は、「どうやって1024本もの配線を、あの小さなチップに収めるのか?」です。 従来の半導体のように、チップの端っこから金線(ワイヤー)を伸ばして基板に繋ぐ「ワイヤボンディング」では、数千本もの配線を引くスペースなど物理的に存在しません。
そこで生み出されたのが、ウエハに直接垂直な穴を開ける**「TSV(Through-Silicon Via:シリコン貫通電極)」**です。
髪の毛より遥かに薄いシリコンを串刺しにする
TSVの製造工程は、もはや精密機械加工というよりナノレベルの土木工事です。
- 極限の薄研削(バックグラインド): DRAMチップをそのまま重ねると分厚くなりすぎるため、シリコンウエハの裏面を物理的・化学的に削り、**数十マイクロメートル(髪の毛の太さの半分以下)**という、触れば破れるサランラップのような極薄のペラペラな状態にします。
- 微細な穴を開ける(エッチング): プラズマガスなどを用いて、シリコンウエハに直径数マイクロメートルの微細な穴を数万個垂直に掘り抜きます。
- 銅(Cu)を流し込む(メッキ): 絶縁膜を蒸着したあと、穴の中に電気を通す「銅」を隙間なく完全に充填します。
- マイクロバンプで縦に積み上げる: 穴の両端に「マイクロバンプ」と呼ばれる微細なハンダの粒を形成し、DRAMチップを8層、12層、16層と狂いなく垂直に重ね合わせ、熱をかけて一気に溶着(接合)します。
これにより、最上階のDRAMから最下階のロジック層まで、電気信号はわずか数百マイクロメートルという最短距離を垂直に駆け抜けます。距離が圧倒的に短いため、信号の遅延(レイテンシ)も配線抵抗による熱損失も最小限に抑えられます。
4. 2.5Dパッケージング(CoWoS)と「反り(Warpage)」の死闘
TSVによってDRAMを縦に積み上げ、1024本の足を持つHBMタワーが完成しました。 しかし、ここで最後の、そして最大の物理の壁が立ちはだかります。
「このHBMと、隣にあるGPUをどうやって繋ぐのか?」
マザーボードなどに使われる通常の「プリント配線板(有機基板)」は、ガラス繊維とエポキシ樹脂で作られています。どんなに微細加工を施しても、配線の幅や間隔(配線ピッチ)は十数マイクロメートルが限界です。 一方、HBMやGPUの端子ピッチは数マイクロメートル以下。**「配線の密度が違いすぎて、通常のマザーボードには直接ハンダ付けできない」**のです。
シリコンインターポーザー(2.5D実装)の発明
このミスマッチを解決するためにTSMCが実用化したのが、「CoWoS(Chip-on-Wafer-on-Substrate)」に代表される2.5Dパッケージング技術です。
マザーボードの上にチップを直接置くのを諦め、間に**「シリコンインターポーザー」**という巨大なシリコンの板を1枚挟み込みます。 シリコンインターポーザー自体は計算をしない「ただの配線専用の床」ですが、半導体製造用の露光装置を使って回路を焼き付けるため、ナノ単位の超極細配線を高密度に走らせることができます。 この超高密度の床の上に、GPUダイと複数のHBMをミリ単位の距離で並べて配置し、互いを数千〜数万本の配線で直結するのです。
熱膨張率のズレが生む「反り(Warpage)」との戦い
この2.5D構造は、物理学的に極めて繊細で過酷な問題を抱えています。それが**「熱膨張係数(CTE:Coefficient of Thermal Expansion)の不一致」**です。
物質は熱を加えると膨張します。しかし、素材によって伸びる割合が全く異なります。
- シリコン(チップ、インターポーザー):熱であまり膨らまない(約 2.6 ppm/℃)
- 銅(配線、バンプ):そこそこ膨らむ(約 16.5 ppm/℃)
- 有機パッケージ基板・樹脂:めちゃくちゃ膨らむ(約 15〜40 ppm/℃)
ハンダを溶かして接合するとき、あるいはAIの計算でチップが80℃〜90℃の熱を持ったとき、**「下の基板は大きく伸びようとするのに、上のシリコンは伸びない」**という強烈な引っ張り合い(熱応力)が内部で発生します。
この力によって、基板全体が煎餅のように反り返ってしまいます(Warpage現象)。 基板が数マイクロメートル反っただけで、並んだ数万個のマイクロバンプの一部が引きちぎれて断線するか、隣のバンプと接触してショートし、何百万円もするAIチップが一瞬でスクラップになります。
これを防ぐため、チップと基板の隙間に特殊な樹脂(アンダーフィル)を毛細管現象で隙間なく流し込み、熱応力を均一に逃がす高度な材料技術や、超精密な圧力で樹脂を押し固める「コンプレッション・モールディング装置(TOWAなど)」が、世界の半導体サプライチェーンの急所として君臨しているのです。
結論:HBMは「半導体前工程」と「パッケージ後工程」の融合点
かつて、半導体産業の花形は「ウエハ上にいかに微細な回路を焼き付けるか」という前工程(露光・微細化)でした。チップを切り出して箱に詰める後工程(パッケージング)は、付加価値の低い「単純作業」と見なされていました。
しかし、微細化が物理限界に近づき、「メモリの壁」が立ちはだかった現代、勝負を決めているのは**「チップをいかに立体的に積み上げ(TSV)、いかにナノ単位の配線で隙間なく平坦に繋ぎ止めるか(2.5D実装)」**という後工程の物理です。
SK hynixが時価総額を急拡大させ、TSMCのCoWoSキャパシティが世界のAIサーバーの生産上限(チョークポイント)となり、日本の微細装置・素材メーカーが喉元を握る理由。 それは、AIの覇権が「トランジスタの小ささ」から、**「限界までデータを高速に流し込むための、立体配線と熱力学の戦い」**へと完全に移行したからに他なりません。
📝 3行で頭に入る『試験・実務・投資の要点まとめ』
- 【メモリの壁】 演算器(GPU)の進化にDRAMのデータ転送速度が追いつかず、AIの推論速度は「メモリ帯域幅(GB/s)」によって完全に律速されている。
- 【HBMの物理】 周波数を上げる限界を突破するため、極薄DRAMをTSV(シリコン貫通電極)で多層積層し、1024bit超の狂気的なバス幅(車線数)で並列転送を実現した。
- 【2.5Dの急所】 GPUとHBMを繋ぐにはシリコンインターポーザー(TSMC CoWoS等)が必須。素材ごとの熱膨張率の差による「反り(Warpage)」を抑えるモールディング装置や材料が世界製造のチョークポイント。