ソケット通信で作る「最小のHTTP/1.1 Webサーバー」――フレームワークをすべて剥ぎ取った先に現れる「平文テキストの物理」
1. 素朴な疑問:ブラウザのアドレスバーでEnterを押したとき、線の中を何が流れるのか?
普段、私たちはWeb開発をするときにNext.js、Express、FastAPI、あるいはGoやJavaのWebフレームワークを使っています。
コードを数行書き、npm run dev や uvicorn main:app と叩けば、ブラウザから簡単にアクセスできるWebサーバーが立ち上がります。
しかし、立ち止まって考えてみてください。
ブラウザのアドレスバーに http://localhost:8080/hello と入力してEnterキーを押したその瞬間、パソコンの内部やネットワークケーブルの中を、一体どんなデータが駆け抜けているのでしょうか?
「JSONやHTMLが飛んでいる」 「バイナリのパケットがやり取りされている」
どれも正解の一部ですが、核心を突いてはいません。 フレームワークやミドルウェア(NginxやApache)の皮をすべて剥ぎ取ったとき、そこに現れるWebの正体は、拍子抜けするほど原始的です。
それは、**「ただの英語の平文テキスト(文字列)を、改行記号で区切って送りつけているだけ」**です。
Webの屋台骨を支えるHTTP(Hypertext Transfer Protocol)とは、決して複雑怪奇なバイナリプロトコルではありません。人間が目で読んで理解できる「テキストの会話ルール」に過ぎないのです。
今回は、サードパーティ製ライブラリを一切使わず、OS標準の「ソケット通信(Socket API)」だけを使って、実際にChromeやSafariからアクセスできる最小のHTTP/1.1 WebサーバーをPythonでゼロから自作します。
2. ネットワークの土台:OSが提供する「ソケット」という仮想土管
Webサーバーを作る前に、まず避けて通れないのが**「ソケット(Socket)」**の理解です。
コンピュータがインターネット越しに通信するとき、物理層ではパケットと呼ばれる細切れの電気信号や光信号が飛び交っています。パケットは途中で順番が前後したり、ノイズで消滅したりします。 しかし、Webプログラマーが毎回「パケットの消失や順序入れ替え」を手動でケアしていたら、Web開発など到底成り立ちません。
そこでOS(カーネル)が提供してくれる抽象化の仕組みが**「TCPソケット」**です。
ソケットとは「ネットワークに繋がったファイル」である
UNIXの有名な設計哲学に**「Everything is a file(すべてはファイルである)」**という言葉があります。 ソケットも例外ではありません。OSから見れば、ソケットとは「ハードディスクのファイル」と全く同じです。
- ハードディスクのファイル:
read()すると磁気ディスクからデータが読め、write()するとディスクに書き込まれる。 - TCPソケット:
read()(またはrecv())すると地球の裏側から届いたデータが読め、write()(またはsend())すると相手のPCへデータが送り出される。
Webサーバーの仕事とは、突き詰めれば**「クライアントから繋がってきたソケットから文字を読み出し、ルールに従った返事の文字をソケットへ書き込むこと」**、ただそれだけに尽きます。
3. HTTP/1.1プロトコルの解剖:RFCで定められた厳格なテキスト規則
では、そのソケットという土管に「どんなフォーマットの文字列」を流し込めば、ブラウザはWebページとして認識してくれるのでしょうか? それを定めた世界共通のルールが**HTTP/1.1(RFC 9112)**です。
① ブラウザが送ってくる「HTTPリクエスト」の構造
ブラウザがサーバーに接続した瞬間、ソケットには以下のようなテキストが流し込まれてきます。
GET /hello HTTP/1.1\r\n
Host: localhost:8080\r\n
User-Agent: Mozilla/5.0 ...\r\n
Accept: text/html\r\n
\r\nここで最も重要な物理的ルールが、改行コードの**「\r\n(CRLF:キャリッジリターン+ラインフィード)」と、「連続する2つの改行(\r\n\r\n:空行)」**です。
コンピュータの通信はバイトのストリーム(川の流れ)なので、「どこでヘッダーが終わり、どこからが本文(ボディ)なのか」を明確に区切る印が必要です。HTTPでは、**「何も文字が書かれていない空行(\r\n)が現れた瞬間、ヘッダーは終わりである」**と定義されています。
② サーバーが返すべき「HTTPレスポンス」の構造
自作サーバーは、受け取ったテキストから「相手が何を要求しているか(パスやメソッド)」を解読し、以下のフォーマットに寸分違わず整えたテキストをソケットに書き戻さなければなりません。
HTTP/1.1 200 OK\r\n
Content-Type: text/html; charset=utf-8\r\n
Content-Length: 46\r\n
Connection: close\r\n
\r\n
<h1>Hello, bare-metal HTTP world!</h1>- ステータスライン:
HTTP/1.1 200 OK\r\n(プロトコルバージョン、3桁のステータスコード、テキストの説明)。 - ヘッダー部: データの種類を教える
Content-Type、データの厳密なバイト数を教えるContent-Lengthなど。 - 空行:
\r\n(ヘッダー終了の合図)。 - メッセージボディ: ブラウザの画面に表示させたいHTMLの実データ。
もし Content-Length の数値を1バイトでも間違えると、ブラウザは「まだデータが届くはずだ」と勘違いしてタブのローディングアイコン(スピナー)をグルグル回し続けたり、途中で画面の描画を打ち切ったりします。Webのすべての挙動は、この厳密な文字数勘定に支配されているのです。
4. 完全実装:Pythonの標準ソケットで作る最小Webサーバー
能書きはここまでです。実際に動くコードを書いてみましょう。
外部ライブラリ(FlaskやFastAPIなど)は一切インポートしません。Pythonの標準機能 socket だけで組み上げます。
ファイル名を server.py として保存してください。
import socket

def run_server(host="127.0.0.1", port=8080):
    # 1. TCPソケットの作成 (IPv4, TCPストリーム)
    server_socket = socket.socket(socket.AF_INET, socket.SOCK_STREAM)

    # サーバー再起動時に「Address already in use」エラーを防ぐソケット設定
    server_socket.setsockopt(socket.SOL_SOCKET, socket.SO_REUSEADDR, 1)

    # 2. ポートの束縛 (bind) と 接続待ち受け (listen)
    server_socket.bind((host, port))
    server_socket.listen(5)
    print(f"[*] サーバーが起動しました: http://{host}:{port}")

    try:
        while True:
            # 3. クライアントからの接続を受け入れる (3ウェイ・ハンドシェイク完了までブロック)
            client_socket, client_address = server_socket.accept()
            print(f"\n[+] 接続を検知: {client_address}")

            # 4. クライアントが送ってきた生バイト列を受信
            request_data = client_socket.recv(4096)
            if not request_data:
                client_socket.close()
                continue

            # バイト列を文字列にデコードして表示
            request_text = request_data.decode("utf-8", errors="replace")
            print("--- 受信したHTTPリクエスト ---")
            print(request_text.strip())
            print("------------------------------")

            # 5. リクエストの解読 (リクエストラインのパース)
            lines = request_text.split("\r\n")
            request_line = lines[0]  # 例: "GET /hello HTTP/1.1"
            parts = request_line.split(" ")

            if len(parts) >= 2:
                method = parts[0]
                path = parts[1]
            else:
                method, path = "GET", "/"

            # 6. ルーティングとHTMLコンテンツの生成
            if path == "/":
                status = "200 OK"
                body = "<html><body><h1>Minimal Web Server</h1><p>Welcome to bare-metal HTTP!</p></body></html>"
            elif path == "/hello":
                status = "200 OK"
                body = "<html><body><h1>Hello, Engineer!</h1><p>Framework-free response.</p></body></html>"
            else:
                status = "404 Not Found"
                body = "<html><body><h1>404 Not Found</h1><p>The page does not exist.</p></body></html>"

            # ボディのバイト数を厳密に計算
            body_bytes = body.encode("utf-8")
            content_length = len(body_bytes)

            # 7. HTTP/1.1レスポンスの組み立て (CRLF区切り)
            response_headers = (
                f"HTTP/1.1 {status}\r\n"
                f"Content-Type: text/html; charset=utf-8\r\n"
                f"Content-Length: {content_length}\r\n"
                f"Connection: close\r\n"
                f"\r\n"
            )

            # 8. ソケットへヘッダーとボディを書き込み、切断
            client_socket.sendall(response_headers.encode("utf-8"))
            client_socket.sendall(body_bytes)
            client_socket.close()

    except KeyboardInterrupt:
        print("\n[*] サーバーをシャットダウンします。")
    finally:
        server_socket.close()

if __name__ == "__main__":
    run_server()
触って試す:HTTPリクエスト処理のステップ実行
🌐 HTTPリクエスト処理のステップ実行
上のコードがやっている処理を、1段ずつ追ってみましょう。まず試したいリクエストを選び、「次へ」を押してください。存在しないパスを選ぶと、404になる分岐も見られます。
5. 実験と検証:curlとブラウザで「生データ」を覗き見る
ターミナルを開き、スクリプトを実行してください。
$ python3 server.py
[*] サーバーが起動しました: [http://127.0.0.1:8080](http://127.0.0.1:8080)
実験①:curlで通信の内幕を覗く
別のターミナルを開き、通信の詳細を表示する -v(Verbose)オプションをつけてリクエストを送ってみます。
$ curl -v [http://127.0.0.1:8080/hello](http://127.0.0.1:8080/hello)curl側の出力結果:
*   Trying 127.0.0.1:8080...
* Connected to 127.0.0.1 (127.0.0.1) port 8080
> GET /hello HTTP/1.1
> Host: 127.0.0.1:8080
> User-Agent: curl/8.7.1
> Accept: */*
>
< HTTP/1.1 200 OK
< Content-Type: text/html; charset=utf-8
< Content-Length: 72
< Connection: close
<
<html><body><h1>Hello, Engineer!</h1><p>Framework-free response.</p></body></html>
* Closing connection
> で始まっているのがcurlが送ったテキスト、< で始まっているのが自作サーバーがソケットに流し込んだテキストです。
教科書通り、空行(空白の行)を挟んでHTMLボディが綺麗に届き、接続が閉じられたことが確認できます。
実験②:本物のブラウザ(ChromeやSafari)で開く
次に、普段使っているWebブラウザを開き、アドレスバーに http://localhost:8080/hello と打ち込んでEnterを押してみてください。
画面表示:
Hello, Engineer!
Framework-free response.
巨大なフレームワークを使わなくても、私たちが書いたわずか60行の文字列処理スクリプトから、ブラウザは何の疑いもなく美しいWebページを描画してくれます。
サーバーのターミナルログを見てみましょう。
[+] 接続を検知: ('127.0.0.1', 54321)
--- 受信したHTTPリクエスト ---
GET /hello HTTP/1.1
Host: localhost:8080
Connection: keep-alive
sec-ch-ua: "Chromium";v="130", ...
User-Agent: Mozilla/5.0 (Macintosh; Intel Mac OS X 10_15_7) ...
Accept: text/html,application/xhtml+xml...
------------------------------
Chromeは裏で、画面描画のためにこれほど大量のメタデータを「ただのテキスト行」として律儀にソケットへ流し込んでいたのです。
6. 歴史的必然と物理:なぜ改行は \n ではなく \r\n なのか?
この最小Webサーバーを作るとき、多くのエンジニアが「なぜ改行にわざわざ \r\n を使うのか? \n だけでは駄目なのか?」という疑問を抱きます。
Linuxでは改行は \n(Line Feed)1文字だからです。
その理由は、コンピュータ黎明期の物理デバイス、**「テレタイプ端末(機械式タイプライター)」**にまで遡ります。
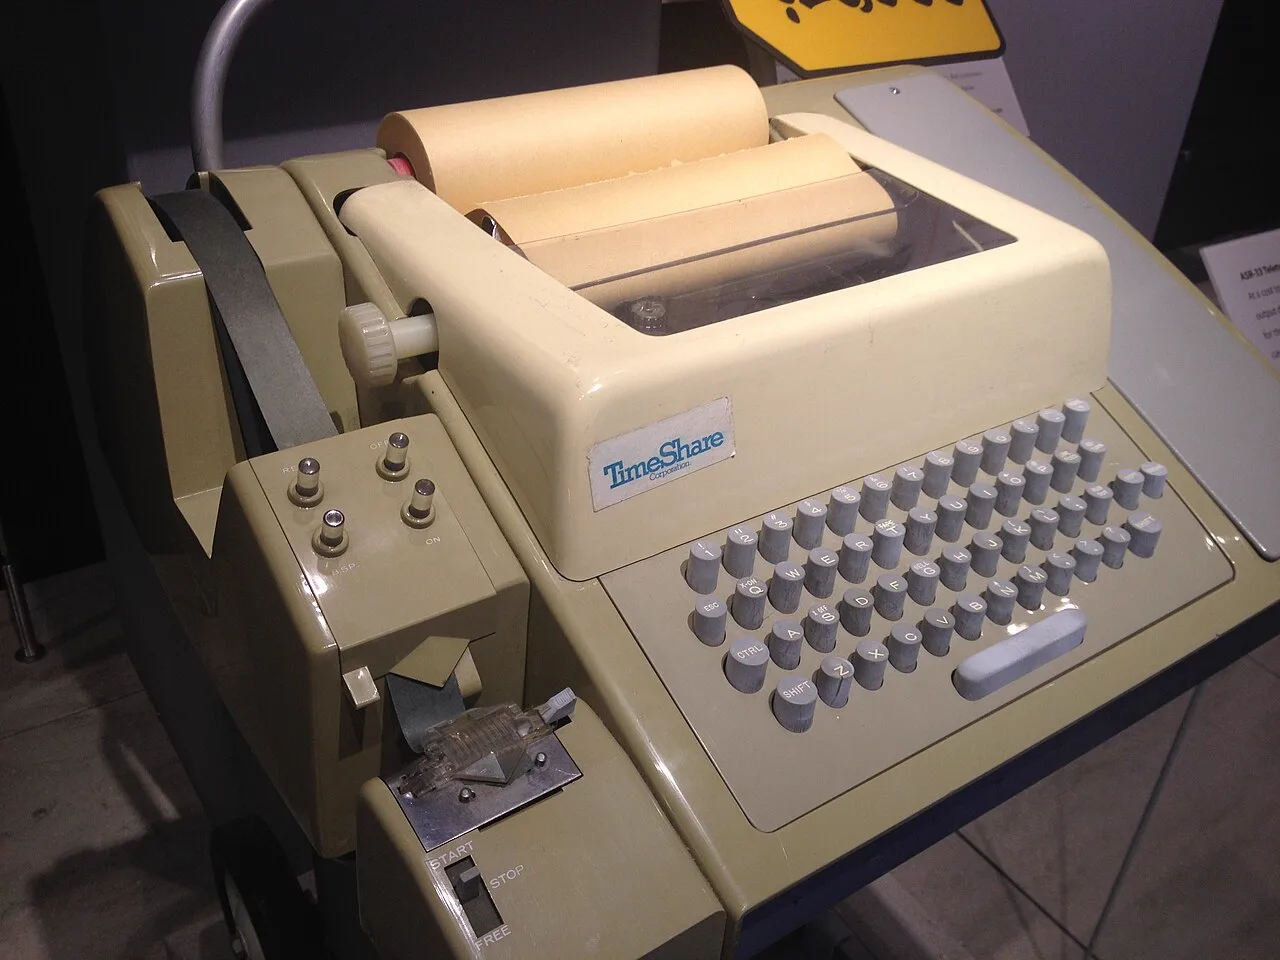
昔の機械式通信機では、「印字ヘッドを左端に戻す時間」と「紙を1行送る時間」に物理的な時間差が必要でした。そのため、ASCIIコードでは \r(復帰)と \n(改行)が明確に別の信号として定義されたのです。
インターネットのプロトコル(Telnet、SMTPメール、FTP、そしてHTTP)が設計された1970〜1990年代、異なるOS(UNIX、Windows、Mac)がネットワーク越しに通信するための共通言語として、**「ネットワーク上の公式な改行記号は必ず \r\n とする(Network Virtual Terminal規則)」**と厳格に定められました。
もしあなたのサーバーが \r\n をサボって \n だけでレスポンスを返すと、古いルーターや厳格なプロキシサーバー、組込みブラウザに到達した瞬間、「不正なプロトコル構文(Bad Request)」として通信を遮断されるリスクを孕むことになります。
私たちがコードに書く \r\n の2バイトには、半世紀に及ぶ通信機器の物理の歴史がそのまま刻み込まれているのです。
7. まとめ:モダンフレームワークは何を隠蔽しているのか?
今回作った最小Webサーバーと、実務で使われるExpress、FastAPI、Django、GoのGinなどのモダンフレームワークとの間にある差は何でしょうか?
本質は、何も変わりません。 あらゆるフレームワークも、OSのソケットを開き、届いた文字列をパースし、レスポンス文字列をソケットに流し込んでいます。
ただ、実用的なフレームワークやWebサーバーは、この50行の上に以下の過酷な現実を肩代わりしてくれているに過ぎません。
- 並行処理と多重化: 今回のコードは1本のループ(同期処理)なので、1人がアクセスしている間は次の人が待たされる。実務ではマルチスレッド、マルチプロセス、あるいは非同期イベントループ(
epoll/kqueue)で数万接続を同時にさばく(C10K問題の解決)。 - 堅牢なパーサー: 悪意あるユーザーがヘッダーの末尾に
\r\n\r\nを送らず接続を占有し続けたり(Slowloris攻撃)、数GBの巨大リクエストを送りつけてきてもメモリ破壊を起こさない防御壁。 - HTTP/2・HTTP/3(QUIC): テキスト形式を捨て、単一接続で複数リクエストを多重化するバイナリフレームや、UDP上で動くパケットロス耐性の実装。
黒魔術のように見えていたWebサーバーも、その内実を一段ずつ解体していけば、そこにあるのは**「ソケットからバイトを読み、RFCの規約通りに文字を切り分け、文字を返す」という純粋な論理の積み重ね**です。
この足元の物理を一度でも体感しておけば、将来どんな新しいWeb技術や高レイヤのフレームワークが登場しようとも、あなたは決して足元を見失うことはありません。
📝 3行で頭に入る『試験・実務の要点まとめ』
- ソケットとHTTPの正体: Web通信の本質はOSが提供するTCP双方向バイトストリーム(ソケット)の上に、RFCで定められた平文テキストを流し込むだけの極めてシンプルな規約である。
- ヘッダーの境界線(CRLF): 各行の終端はテレタイプ端末の物理動作に由来する
\r\nで区切られ、連続する改行(\r\n\r\n:空行)が現れた瞬間が「ヘッダー終了・本文開始」の絶対合図となる。 - Content-Lengthの役割: ストリーム通信ではどこでデータが終わるか自明ではないため、ボディの厳密なバイト数をヘッダーで申告しないとブラウザは読み込み完了を検知できずフリーズする。