なぜ今、再び「CPU」と「SSD」が足りないのか?(HDDからNVMeへの物理史)
AIバブルの初期、データセンター業界や投資家の間では、ある極端な言説がまことしやかに囁かれていました。 「これからはGPUの時代だ。CPUは単なるおまけになり、低速な大容量ストレージに適当にデータを放り込んでおけば、あとはNVIDIAのチップがすべてを解決してくれる」
しかし、数億円から数十億円を投じて最新のGPUサーバークラスタを組み上げた現場で、多くのエンジニアが青ざめる事態に直面しました。 タスクマネージャーや監視ダッシュボードを開くと、1枚数百万円もする超高額なGPUたちの稼働率が「10%〜20%」に張り付いてピクリとも動かないのです。
計算器(GPU)は1秒間に数千兆回もの行列演算を行う準備ができているのに、手元に計算すべきデータが届かない。超一流の巨大工場を建てたのに、資材を運ぶトラックが途中の山道で大渋滞を起こし、工場のラインが丸ごと止まっている状態です。
この「飢餓状態」を救うために今、AIインフラの最前線で再び猛烈な脚光を浴び、激しい争奪戦が起きているのが**「高性能マルチコアCPU」と「超高速エンタープライズNVMe SSD」**です。 なぜ、AIの時代に再びCPUとSSDの性能が決定的なボトルネックになったのか? その謎を解くために、まずは私たちがデータを記録してきた「ストレージの物理史」から紐解いていきましょう。
1. ストレージの物理史:機械仕掛けから「量子トンネル効果」へ
データを永続的に記録するストレージは、過去30年で「力学(マクロな機械工学)」から「量子力学(ミクロな物性物理)」へと、その動作原理を根底から転換させました。
HDD(ハードディスク):時速100kmで飛ぶジャンボジェット機
かつての主役であるHDD(Hard Disk Drive)は、完全に**「精密機械仕掛けの物理装置」です。 磁性体を塗布した円盤(プラッタ)が毎分5,400〜15,000回転という猛スピードで回転し、その上空わずか数ナノメートルの隙間を、磁気ヘッドを搭載したアームが物理的に往復します。 これは比喩ではなく、「ジャンボジェット機が地上1ミリの高度を保ちながら、時速数百キロで草の葉の枚数を数えている」**に等しい狂気の機械精度です。
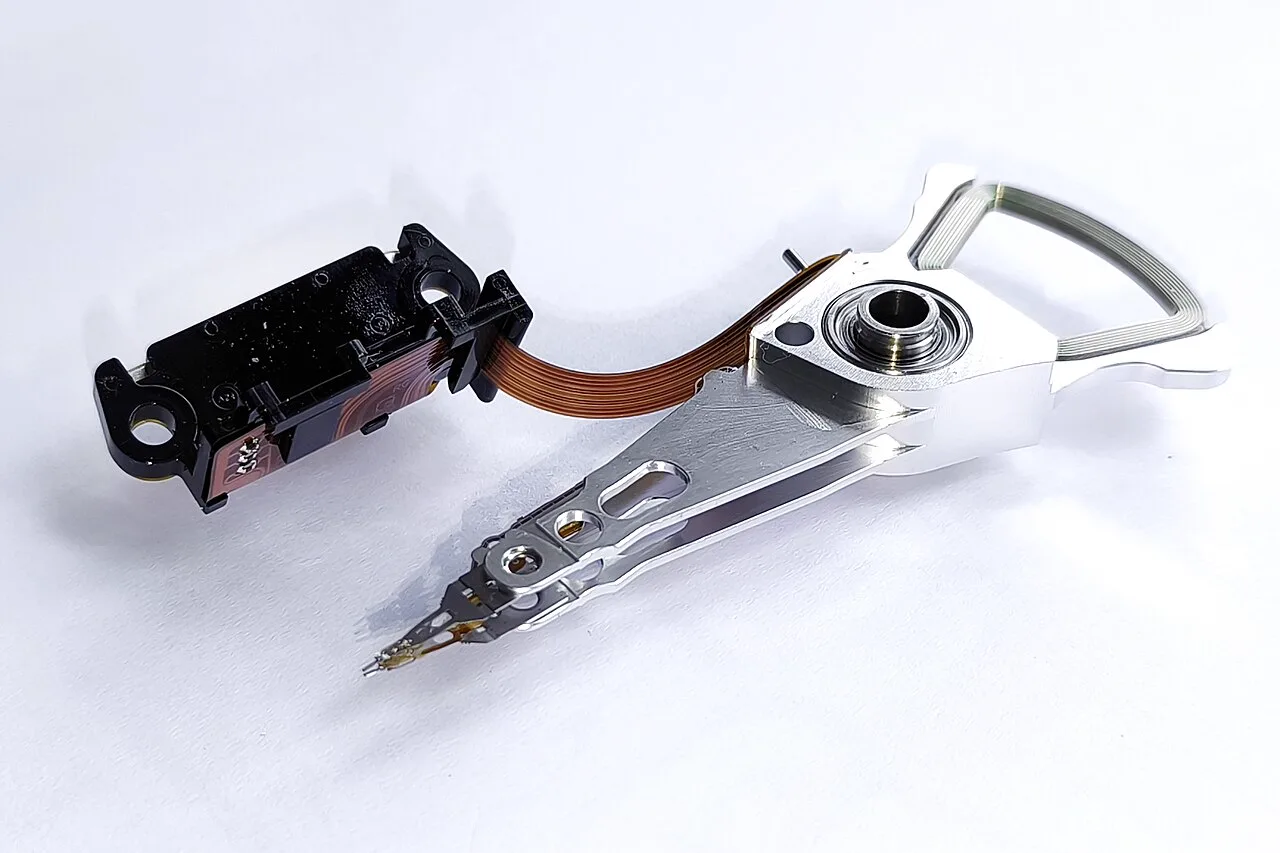
しかし、機械である以上、どれほど頑張っても**「質量を持った金属アームを動かし、目的のデータが回ってくるのを待つ時間(シークタイム+回転待ち時間)」をゼロにはできません。 HDDのアクセス遅延(レイテンシ)は、どんなに速くても数ミリ秒(ms:1,000分の1秒)**かかります。1秒間に数ギガ回のクロックで動くプロセッサから見れば、数ミリ秒の待機時間は「数ヶ月間放置される」に等しい永遠の沈黙でした。
SSD(NANDフラッシュ):電子を絶縁体の檻に閉じ込める
この物理限界を粉砕したのが、NANDフラッシュメモリを使った**SSD(Solid State Drive)**です。SSDには、モーターも回転する円盤もアームもありません。完全な半導体素子です。
NANDフラッシュの内部には、無数の「浮遊ゲート(フローティングゲート)」または「チャージトラップ」と呼ばれる電子の小部屋が格子状に並んでいます。 周囲を頑丈な絶縁膜(酸化膜)で囲まれたこの部屋に、高い電圧をかけて電子をギュッと押し込みます。このとき利用されるのが、量子力学の**「ファウラー・ノルドハイム(FN)トンネル効果」**です。本来なら通り抜けられないはずの絶縁体の壁を、電子が波のようにすり抜けて部屋の中に閉じ込められます。
- 電子が閉じ込められている状態 = データ「0」
- 電子が抜かれている状態 = データ「1」
電源を切っても、絶縁体の壁に阻まれた電子は何年間も逃げ出せません。 可動部が一切ないため、目的のデータがどこにあろうと、電気信号を送った瞬間にアクセスできます。遅延は一気に**数十マイクロ秒(μs:100万分の1秒)**へと、HDDの数百倍から千倍近く短縮されたのです。
触って試す:レイテンシの階段
⏱️ レイテンシの階段(階層を押して、桁の違いを体感)
CPUの1クロック(約0.3ナノ秒)を、人間の「1秒」に置き換えて換算します。各階層のボタンを押すと、実際のアクセス時間と「人間だったらどれくらい待つのか」が表示されます。記事に出てくるSSD(数十マイクロ秒)とHDD(約5〜15ミリ秒)は、そのままの値を使っています。
実際のアクセス時間:
人間の時間に換算すると:
バーは対数スケール(桁の差)を表しています。
2. インターフェースのボトルネック:SATAの細道から「NVMe」の高速道路へ
しかし、記録媒体そのものが半導体(SSD)に進化しても、新たなボトルネックが立ちはだかりました。それが**「通信経路(インターフェース)の規格」**です。
初期のSSDは、HDDのために作られた古い規格である**「SATA(Serial ATA)」**ケーブルに繋がれていました。 SATAは、もともと「のろまな機械式HDD」を想定して設計されたため、以下のような強烈な足枷を抱えていました。
- 帯域の限界:最大でも約600MB/s(実効550MB/s程度)で頭打ちになる。
- 命令の順番待ち(キューの深さ):一度に処理できる命令(コマンド)は**「1本の列で、最大32個まで」**しか溜められない。
超高速にデータを読み出せる半導体チップを積んでいるのに、出口の道路が「幅1車線・制限速度60km」の旧道だったため、SSDはその真価を発揮できずにいました。
このボトルネックを破壊するために作られたのが、現代の標準である**「NVMe(Non-Volatile Memory Express)」**です。
NVMeは、SATAのような中継チップ(チップセット)を完全にバイパスし、プロセッサに直結している超高速バス**「PCIe(PCI Express)」にSSDをダイレクトに接続します。 さらに、並列処理を極限まで活かすため、命令の受け入れ口を「最大64,000本のキュー、それぞれに64,000個のコマンド(合計約40億個の命令)」**を同時に並列処理できるように設計されました。
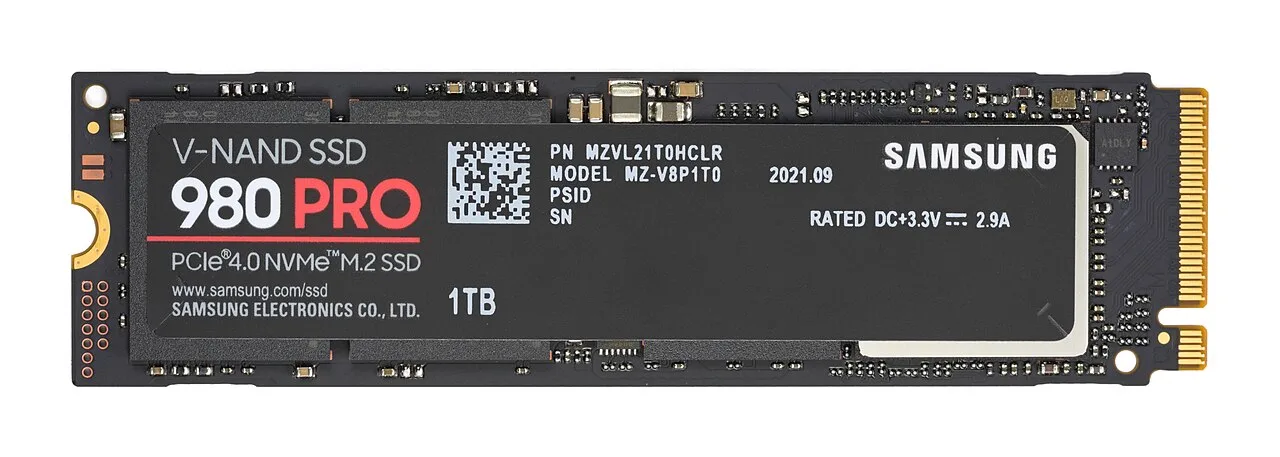
最新の「PCIe Gen5」に対応したエンタープライズNVMe SSDは、1枚で秒間14GB(14,000MB/s)以上という、SATA SSDの20倍以上、HDDの70倍以上のスピードでデータを吐き出します。 これでようやく、ストレージ側のハードウェア準備は整いました。しかし、問題はここから始まる「AI特有のデータ処理」でした。
3. なぜAIはCPUとSSDを食い尽くすのか?(前処理という兵站戦)
AIの学習(Training)とは、何ペタバイトもの膨大なテキスト、高解像度画像、動画、音声データをGPUに流し込み、パラメータを更新し続ける作業です。 ここで多くの人が見落としているのが、**「ストレージにあるデータは、そのままではGPUが理解できない」**という冷酷な事実です。
泥臭い「前処理」はGPUにはできない
ストレージに保存されているデータは、JPEGやPNGで圧縮された画像ファイルであり、ZIPで固められた生テキストであり、MP4でエンコードされた動画です。 これらをGPUの胃袋に放り込むには、以下の膨大なステップをリアルタイムで実行しなければなりません。
- ディスクからの読み出し:SSDから圧縮ファイルを猛スピードで吸い出す。
- 展開とパース:圧縮を解凍し、メタデータを解析する。
- 画像の前処理:デコードし、リサイズし、ランダムに切り抜き(クロップ)、回転させ、色調を補正(正規化)してテンソル形式に変換する。
- テキストの前処理:文字列を形態素に分解し、辞書と照合して「トークンID」の数列へ変換する。
この「前処理(データパイプライン)」は、典型的な**「条件分岐(If文)だらけの処理」**であり、解凍アルゴリズムや文字列操作の連続です。 第1話で解説した通り、GPUはこうした複雑な分岐処理が大の苦手です。GPUに画像のリサイズやテキストのトークナイズをやらせると、万の軍勢のほとんどが遊休化し、極めて非効率になります。
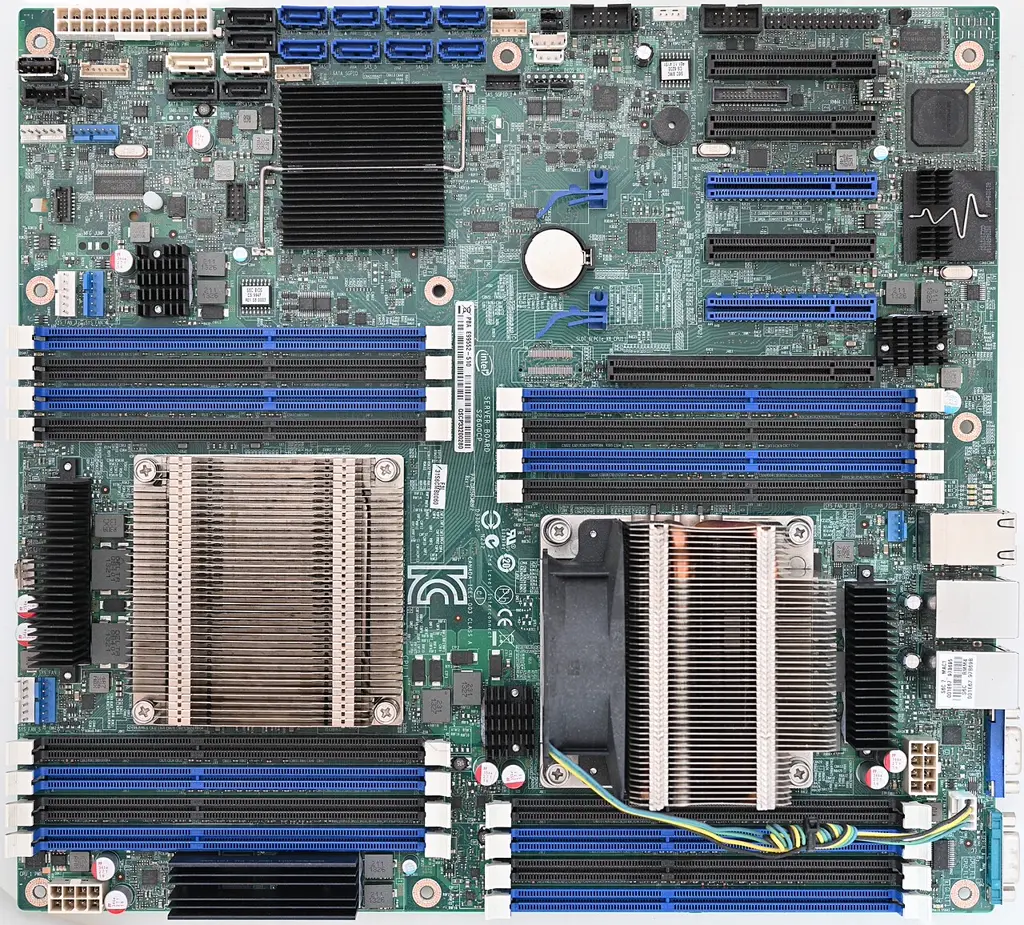
結果として、この泥臭い前処理のすべてを**「CPUの数十〜数百個のコア」**が一手に引き受けることになります。 CPUのコア数が足りない、あるいはSSDからの読み出し速度が追いつかないと、前処理のスピードがGPUの計算速度を下回ります。すると、1枚数百万円のGPUは「次のデータが届くまで何もしないで待つ」という最悪のアイドリング状態に陥るのです。
世界中のAIデータセンターが、最新のGPUだけでなく、64コアや128コアを積んだAMD EPYCやIntel Xeonといった超重量級のサーバーCPU、そして数十テラバイト単位の超高速NVMe SSDを狂ったように買い漁っている真の理由がここにあります。 前処理という「兵站(ロジスティクス)」が途絶えた瞬間、前線の精鋭部隊(GPU)は全滅するのです。
4. ボトルネック破壊技術:GPUDirect Storage(GDS)
しかし、CPUとSSDを強化しても、従来のコンピュータアーキテクチャそのものが抱える「致命的な遠回り」が残っていました。それが**「OSとメモリのバッファコピー」**です。
従来のデータ転送:たらい回しの物理
通常、LinuxなどのOSがSSDからデータを読み込んでGPUに渡す場合、データは以下のような迷路を通らされます。
- NVMe SSDからデータを読み出す。
- 一度、CPUが管理する**「メインメモリ(ホストDRAM)のカーネルバッファ」**に書き込む。
- アプリケーションのメモリ空間へコピーする。
- CPUが介入して、データを**PCIeバス経由でGPUのメモリ(HBM)**へと再送する。
この方式では、データがメインメモリを何往復もし、そのたびにCPUのキャッシュが汚染され、CPUに大量の割り込み処理(コンテキストスイッチ)が発生します。ストレージの読み出し帯域が数十GB/sに達すると、「データの右から左への横流し」だけでCPUが100%使い果たされてしまうのです。
GPUDirect Storage(GDS)の破壊力
この無駄を排除するためにNVIDIAが生み出したアーキテクチャが、**「GPUDirect Storage(GDS)」**です。
GDSは、NVMe SSDとGPUの間で**「DMA(Direct Memory Access)」**を直接実行します。 PCIeスイッチを介して、SSDコントローラからGPUのメモリ(HBM)へ、CPUとホストDRAMを完全に素通り(バイパス)してデータを直接流し込みます。
- CPU負荷の激減:CPUはデータの通り道にならず、最初の転送命令を出すだけで済むため、CPUのリソースを100%「高度な前処理」に専念させられる。
- 遅延の半減と帯域の開放:ホストメモリへの無駄なコピーが消滅し、PCIeの物理限界に近いスピードでNVMeからGPUへデータが直通する。
さらに現在では、この考え方を1台のサーバー内にとどめず、ネットワーク(InfiniBand / RoCE)を越えて別ラックの巨大ストレージアレイからGPUへ直接データを流し込む**「NVMe-oF(NVMe over Fabrics)」**へと進化しています。
結論:AIインフラとは「演算」ではなく「巨大な物流」である
半導体やAIの議論は、どうしても「GPUのFLOPS(計算力)」という派手な数字にスポットライトが当たりがちです。 しかし、現実の物理世界においてシステム全体の性能を決定づけるのは、常に**「最も流れの遅いボトルネック」**です。
どれほど鋭い包丁(GPU)を持っていても、まな板の上に食材を運ぶトラック(NVMe SSD)が遅ければ料理は作れません。食材の皮を剥き、骨を抜く下ごしらえ係(マルチコアCPU)がいなければ、包丁人は立ち尽くすしかありません。
機械式の円盤(HDD)を捨て、電子のトンネル効果(SSD)を手に入れ、バスを直結し(NVMe)、OSのオーバーヘッドすらバイパスする(GPUDirect)。 AIインフラの覇権とは、計算器の進化である以上に、**「ナノ秒からミリ秒まで、あらゆる階層で発生するデータの渋滞を徹底的に撲滅する物流戦争」**そのものなのです。
📝 3行で頭に入る『試験・実務・投資の要点まとめ』
- 【ストレージの物理】 HDDは機械駆動(数ms)の遅延が限界だったが、SSDはNANDフラッシュの量子トンネル効果により電子制御(数μs)へ進化し、並列処理に特化したNVMeでPCIe直結を果たした。
- 【CPUの再評価】 AI学習では生データの解凍・リサイズ・トークナイズ等の「泥臭い前処理(If文の塊)」が必須であり、これが遅れるとGPUが飢餓停止するため、超多コアCPUの需要が爆発している。
- 【GDSの革命】 従来のOS・ホストDRAMを中継するバッファコピーを廃止し、NVMe SSDからGPUメモリ(HBM)へDMA直送する「GPUDirect Storage」が、I/OとCPU負荷のボトルネックを打ち破った。