メモリとファイルで作る「最小のキーバリューストア(LSM/WAL)」――電源が落ちてもデータが消えない物理の境界線
1. 素朴な疑問:なぜ電源コードを引っこ抜いてもデータは消えないのか?
「データベースに保存したデータは、サーバーの電源プラグが突然引っこ抜かれても、なぜ絶対に消えずに残っているのか?」 「ディスク(SSD/HDD)への書き込みはメモリより10万倍以上遅いはずなのに、なぜ最新のデータベースは何万件もの書き込みを1秒間で平然とさばけるのか?」
Webエンジニアなら誰もが日常的にSQLを叩き、あるいはRedisやMongoDBにデータを保存しています。 しかし、その足元にある「揮発性のメモリ(RAM)」と「不揮発性のストレージ(SSD/HDD)」の間には、深くて暗い物理の断絶が横たわっています。
メモリ上で data["user_1"] = "Alice" と書き換えるだけなら、わずか数十ナノ秒で終わります。しかし、サーバーが停電した瞬間にすべてのデータは宇宙の彼方へ消え去ります。
一方、毎回律儀にディスクのファイルを更新していては、ディスクの遅さに引っ張られてWebサービスはまともに動きません。
「メモリの圧倒的な速度」と「ディスクの絶対的な永続性」。 この矛盾する2つの物理特性を調停するために、すべての現代データベース(MySQL、PostgreSQL、RocksDB、Cassandra、SQLiteなど)が採用している基本アーキテクチャが**「WAL(Write-Ahead Logging:先行書き込みログ)」と「LSM(Log-Structured Merge-tree)」**です。
今回は、外部ライブラリを一切使わず、Pythonの標準ファイル操作だけで「電源が落ちても瞬時に自己復元する最小のキーバリューストア(KVS)」をゼロから実装します。
2. 物理の壁:ランダムI/O(地獄の探索)vs シーケンシャルI/O(爆速追記)
データベースの性能を決定づける最大の物理的要因は、**「ディスクにどう書き込むか」**です。 ディスクへのアクセスには、天と地ほど性能が異なる2つの方法があります。
① ランダムI/O(Random I/O)の悲劇
「すでにディスク上にあるファイルを開き、300バイト目の位置にあるデータを新しい値に書き換える」ような処理です。
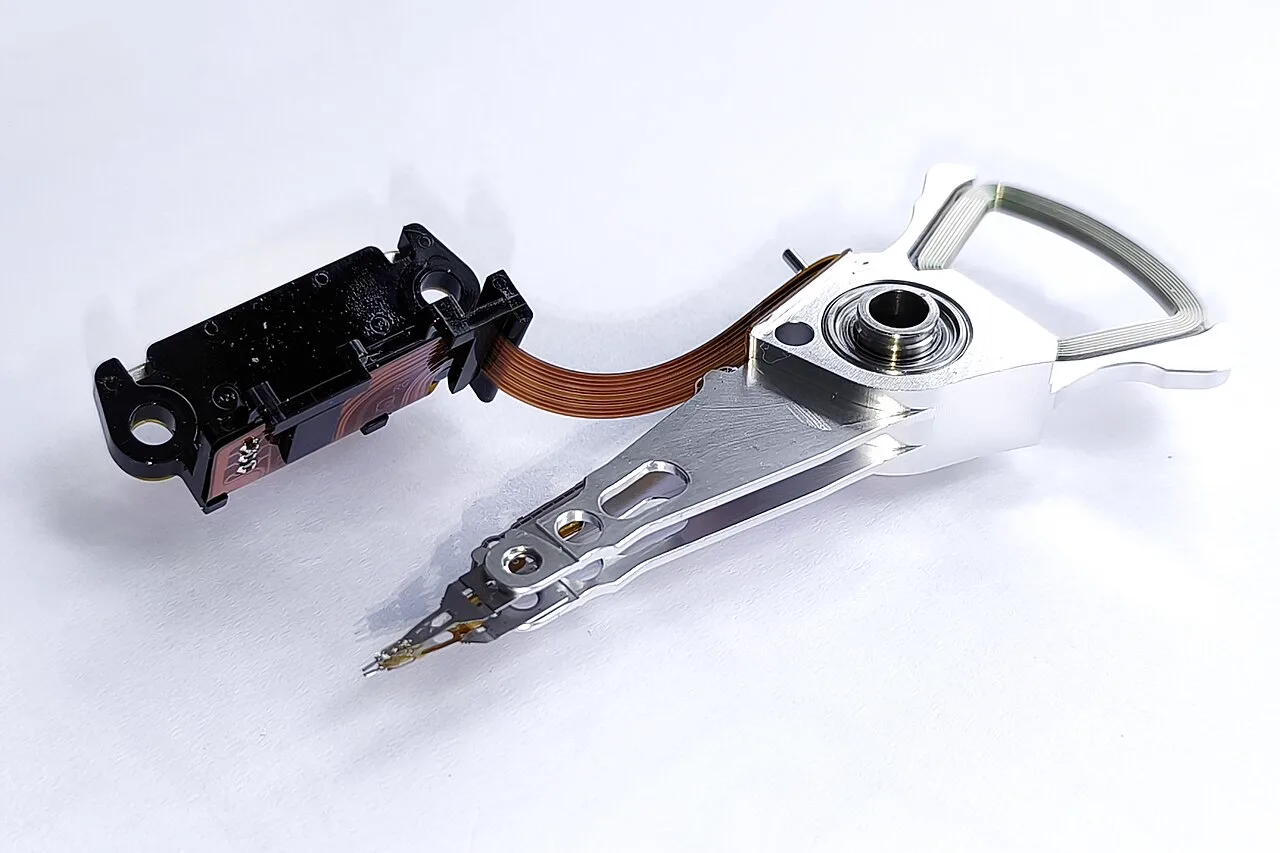
- HDDの場合: アームが物理的に移動し、磁気ディスクが回転して目的の場所がヘッドの下に来るまで待たなければなりません(シーク時間:数ミリ秒)。秒間に数百回アクセスするのが限界です。
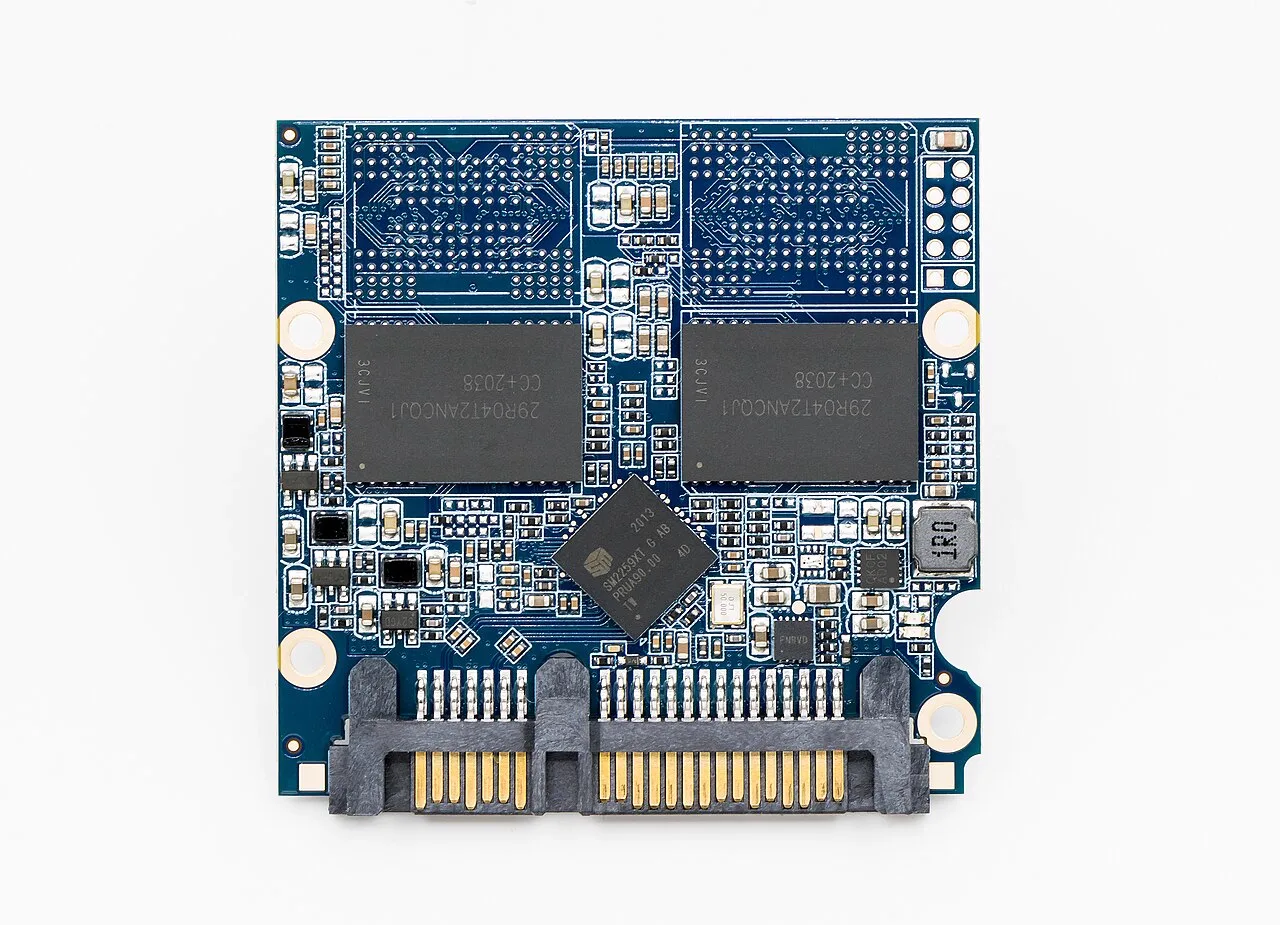
- SSDの場合: 物理的なアームはありませんが、NANDフラッシュメモリは「既存のデータを上書き」できません。一度「ブロック(数MB)」ごとデータを消去してから書き直す必要があり(ライトアンプリフィケーション)、激しい性能低下と寿命の摩耗を引き起こします。

② シーケンシャルI/O(Sequential I/O)の奇跡
一方、「ファイルの途中はいじらず、常にファイルの『一番最後の行』に新しいデータを追記(Append)するだけ」にすると、世界が一変します。 ヘッドは移動せず、SSDのブロック消去も不要で、連続した領域へ一直線にデータが流し込まれます。その速度はランダムI/Oの数百倍〜数千倍に達し、ディスクでありながらメモリの帯域に迫る性能を発揮します。
現代の高性能データベースの鉄則はただ1つ。 **「ディスクに対して、途中の上書き(ランダムI/O)を絶対にさせるな。すべてを末尾追記(シーケンシャルI/O)で終わらせろ」**です。
3. アーキテクチャの骨格:WALとMemTableの二重奏
この「末尾追記の物理」をシステム設計に昇華させたのが、以下の2層アーキテクチャです。
1. WAL(Write-Ahead Log:先行書き込みログ)
「何月何日、キーAの値をBにした」という変更ログを、ディスク上の1本のファイル(WAL)の末尾へひたすらシーケンシャル追記していきます。 **「実データを整理して保存する前に、まず何よりも先にログをディスクに刻む」**ことから「先行書き込み(Write-Ahead)」と呼ばれます。この1行がディスクに触れた瞬間、データベースはクラッシュしてもデータを失わない「耐久性(Durability)」を獲得します。
2. MemTable(インメモリテーブル)
読み取り(get)を高速化するため、メモリ上にも全く同じデータをPythonの dict(実務では赤黒木やSkipListなどのソート済みデータ構造)として保持します。
読み込みリクエストが来たら、遅いディスクは一切見に行かず、メモリ上の辞書から直接 $O(1)$ で爆速で返答します。
3. クラッシュリカバリ(自己復元)
もし作業の途中で誰かが電源プラグを引き抜き、PCが強制終了したらどうなるでしょうか? メモリ上の辞書(MemTable)は一瞬で跡形もなく消滅します。
しかし、ディスクには**「過去に行われたすべての操作が時系列順に刻まれたWALファイル」が無傷で残っています。 再起動した瞬間、データベースはWALファイルを先頭から1行ずつ読み込み、メモリ上の辞書へ向けて操作を忠実に「再上映(リプレイ)」**します。すると、わずか数ミリ秒で電源が切れる直前と完全に同一のメモリ状態が蘇るのです。
4. fsync の深淵:OSの「嘘」を見破る物理命令
ここで、低レイヤのエンジニアが決して見落としてはならない、OSとハードウェアの巨大な罠があります。 それが**「OSのページキャッシュ(バッファ)」**です。
Pythonで file.write("data") を呼んだとき、あなたの書いたデータは、実はまだハードディスクやSSDのシリコン素子には1ビットも届いていません。
OSは親切心から、「ディスクに書くのは遅いから、とりあえずOSの管理するメモリ(ページキャッシュ)にデータを預かっておき、アプリケーションには『書き終わったよ』と嘘の返事をして処理を進めさせよう。実際のディスクへは、あとで手の空いたときにまとめて流し込もう」と判断します。
この遅延書き込みの最中に電源が落ちると、「書き込み完了の通知をもらっていたはずのデータ」が綺麗サッパリ消滅します。これはリレーショナルデータベースにおけるACID特性の「D(Durability:永続性)」の完全な崩壊を意味します。
これを防ぐ唯一の手段が、OSに対して「小細工はいいから、今すぐ物理ディスクの磁気面/フラッシュ素子にデータを叩き込め!」と強制命令を下すシステムコール、**fsync()(Pythonでは os.fsync())**です。
fsync を呼ぶと、物理ドライブへの書き込みが電気的に完了するまでプロセスがブロック(一時停止)されます。これこそが、データベースが真の安全性を手に入れるための「物理の代償」なのです。

5. 完全実装:Pythonで作る最小のキーバリューストア
それでは、ここまでの理論を凝縮した最小のKVSを実装します。
外部ライブラリは一切使用しません。ファイル名は min_kvs.py として保存してください。
import os
import json

class MinKVS:
    def __init__(self, db_path="data.wal"):
        self.db_path = db_path
        self.memtable = {}  # メモリ上の高速な作業机 (MemTable)
        self.wal_file = None

        # 1. 起動時リカバリ:既存のWALファイルがあれば読み込んでメモリを完全復元
        self._recover()

        # 2. 追記専用(Append-Only)でWALファイルを開く
        self.wal_file = open(self.db_path, "a", encoding="utf-8")

    def _recover(self):
        """WALファイルを最初から再生(リプレイ)し、メモリをクラッシュ前の状態に戻す"""
        if not os.path.exists(self.db_path):
            print("[*] 既存のWALなし。新規データベースを開始します。")
            return

        print("[*] WALからクラッシュリカバリ中...")
        count = 0
        with open(self.db_path, "r", encoding="utf-8") as f:
            for line in f:
                line = line.strip()
                if not line:
                    continue
                # ログの1行をデコード
                entry = json.loads(line)
                op = entry["op"]
                key = entry["key"]

                if op == "PUT":
                    self.memtable[key] = entry["val"]
                elif op == "DELETE":
                    self.memtable.pop(key, None)
                count += 1
        print(f"[+] リカバリ完了: {count} 件のログを再上映し、MemTableを復元しました。")

    def put(self, key: str, value):
        """データの保存: WALへの追記(シーケンシャルI/O) -> MemTableの更新"""
        entry = {"op": "PUT", "key": key, "val": value}
        line = json.dumps(entry) + "\n"

        # 1. 先行書き込みログ(WAL)へシーケンシャル追記
        self.wal_file.write(line)
        self.wal_file.flush()

        # 2. 物理ディスクへの書き込みを強制保証(ACIDのDurability)
        os.fsync(self.wal_file.fileno())

        # 3. メモリ上の辞書を更新
        self.memtable[key] = value

    def get(self, key: str):
        """データの取得: ディスクは見ず、メモリから O(1) で爆速返答"""
        return self.memtable.get(key, None)

    def delete(self, key: str):
        """データの削除: 削除したという事実(墓石:Tombstone)をWALに刻む"""
        if key not in self.memtable:
            return

        entry = {"op": "DELETE", "key": key}
        line = json.dumps(entry) + "\n"

        self.wal_file.write(line)
        self.wal_file.flush()
        os.fsync(self.wal_file.fileno())

        del self.memtable[key]

    def close(self):
        if self.wal_file and not self.wal_file.closed:
            self.wal_file.close()


# -------------------------------------------------------------
# 実験:クラッシュ&自己復元シミュレーション
# -------------------------------------------------------------
if __name__ == "__main__":
    DB_FILE = "test_store.wal"
    if os.path.exists(DB_FILE):
        os.remove(DB_FILE)

    print("=== フェーズ1: データベースへデータを書き込む ===")
    db = MinKVS(DB_FILE)
    db.put("user_1", {"name": "Alice", "role": "admin"})
    db.put("user_2", {"name": "Bob", "role": "editor"})
    db.put("user_3", {"name": "Charlie", "role": "viewer"})

    # 値の更新と削除を試す
    db.put("user_1", {"name": "Alice", "role": "superadmin"})
    db.delete("user_2")

    print("\n【書き込み直後のメモリ状態】")
    print(f"user_1: {db.get('user_1')}")
    print(f"user_2: {db.get('user_2')} (削除済み)")
    print(f"user_3: {db.get('user_3')}")

    print("\n=== フェーズ2: 突然のクラッシュ!(電源遮断をシミュレート) ===")
    # close() を呼ばず、メモリ上のインスタンス(db)を意図的に強制破棄
    del db
    print("[!] プロセスが強制終了し、メモリ上の全データ(MemTable)が完全に消滅しました。")

    print("\n=== フェーズ3: サーバーの再起動と自動復元 ===")
    # 新しいインスタンスを生成して、ファイルからデータが蘇るか確認
    recovered_db = MinKVS(DB_FILE)

    print("\n【復元後のメモリ状態】")
    print(f"user_1: {recovered_db.get('user_1')}")
    print(f"user_2: {recovered_db.get('user_2')}")
    print(f"user_3: {recovered_db.get('user_3')}")

    print("\n=== フェーズ4: ディスク上の生ログ(WAL)を覗いてみる ===")
    recovered_db.close()
    with open(DB_FILE, "r", encoding="utf-8") as f:
        print(f.read().strip())
6. 実験と検証:クラッシュからの生還劇を目撃する
ターミナルでスクリプトを実行してみましょう。
$ python3 min_kvs.py実行結果の出力ログ
=== フェーズ1: データベースへデータを書き込む ===
[*] 既存のWALなし。新規データベースを開始します。

【書き込み直後のメモリ状態】
user_1: {'name': 'Alice', 'role': 'superadmin'}
user_2: None (削除済み)
user_3: {'name': 'Charlie', 'role': 'viewer'}

=== フェーズ2: 突然のクラッシュ!(電源遮断をシミュレート) ===
[!] プロセスが強制終了し、メモリ上の全データ(MemTable)が完全に消滅しました。

=== フェーズ3: サーバーの再起動と自動復元 ===
[*] WALからクラッシュリカバリ中...
[+] リカバリ完了: 5 件のログを再上映し、MemTableを復元しました。

【復元後のメモリ状態】
user_1: {'name': 'Alice', 'role': 'superadmin'}
user_2: None
user_3: {'name': 'Charlie', 'role': 'viewer'}

=== フェーズ4: ディスク上の生ログ(WAL)を覗いてみる ===
{"op": "PUT", "key": "user_1", "val": {"name": "Alice", "role": "admin"}}
{"op": "PUT", "key": "user_2", "val": {"name": "Bob", "role": "editor"}}
{"op": "PUT", "key": "user_3", "val": {"name": "Charlie", "role": "viewer"}}
{"op": "PUT", "key": "user_1", "val": {"name": "Alice", "role": "superadmin"}}
{"op": "DELETE", "key": "user_2"}
なぜ元通りに復元されたのか?
フェーズ4で出力されたディスク上の生ログ(test_store.wal)に注目してください。
- 歴史の積み上げ:
user_1のデータは途中で上書きされ、user_2は削除されましたが、ディスク上のファイルは昔の行を1文字も削っていません。 ただ後ろへ後ろへと出来事が追記されています。 - 削除の正体(墓石:Tombstone):
データベースにおいて、「削除」とはデータをディスクから消し去ることではありません。**「
{"op": "DELETE"}という死亡宣告のマーカー(墓石)を末尾に追記すること」**です。 - リプレイによる状態収束:
再起動時、古い
user_1(admin)が一度メモリにセットされた後、直後に現れた新しいuser_1(superadmin)が自然に上書きしました。そしてuser_2は最後のDELETEログによって辞書から消去されました。
この「歴史をそのまま再生すれば現在に辿り着く」という極めて原始的な事実こそが、世界中のすべてのデータベースがクラッシュから生還できる理由なのです。
触って試す:KVストア操作の体験
🗄️ KVストア操作の体験(WAL追記とリプレイ復元)
キーと値を入力して PUT / GET / DELETE を試してください。下の左が現在の状態(MemTable:メモリ上の表)、右が出来事の記録(WAL:ディスク上の追記ログ)です。同じキーでPUTし直しても古い行は消えず、ログが後ろへ伸びていく様子を見てください。最後に「クラッシュ&再起動」で、ログのリプレイによる復元も体験できます。
🧠 MemTable(メモリ上の表)
💾 WAL(ディスク上の追記ログ)
まずは PUT を押してみてください。
7. 発展:LSMツリー(Log-Structured Merge-tree)の必然
「でも、このままだと何ヶ月も運用したらWALファイルが何百GBにも肥大化して、再起動時のリカバリに何時間もかかるのでは?」
鋭い疑問です。その通りで、このままではいつかディスクがパンクし、起動時間が無限に延びてしまいます。 そこでGoogleのBigtable、そしてMeta(旧Facebook)が開発したRocksDBなどの最先端ストレージエンジンが導入したのが、**「LSMツリー(Log-Structured Merge-tree)」**です。
SSTableとコンパクションの幾何学
- SSTable(Sorted String Table): メモリ上のMemTableが一定サイズ(例えば64MB)に達すると、メモリ内のデータを「キーの辞書順」に並び替えて、ディスク上へ1本の新しい不変ファイル(SSTable)として一括でドカンと書き出します(フラッシュ)。この書き出しも完全なシーケンシャルI/Oです。
- WALのローテーション: SSTableへの書き出しが成功した時点で、それ以前の古いWALログは不要になるため、安全に削除(または切り捨て)できます。
- コンパクション(Compaction:整地処理): 裏側のバックグラウンドスレッドで、複数のSSTable同士を「マージソート」のように突き合わせ、上書きされた古い値や「DELETE(墓石)」がついた死にデータを綺麗に削ぎ落として、1つの整理された新しいSSTableへと統合します。
どんなに巨大なシステムになろうとも、基本思想は変わりません。 「書き込みはすべてメモリとシーケンシャル追記で瞬時に終わらせ、ディスクの整理整頓は裏で暇なときにやる」。 この時間差攻撃こそが、現代のビッグデータを支えるLSMアーキテクチャの真骨頂なのです。
8. まとめ:データベースとは「現在と未来の調停装置」である
私たちが書いたわずか70行のスクリプトと、何十万行ものC++で書かれたエンタープライズデータベースとの間にある差は何でしょうか?
本質は、何も変わりません。
- メモリ(MemTable)は「現在」のためにある: ユーザーに1ミリ秒でも速くデータを返すための空間。
- 追記ログ(WAL)は「未来」のためにある: 突然死したとき、過去の歴史を再生して現在を取り戻すための時間。
- fsyncは「物理の契り」である: OSのキャッシュを飛び越え、電子や磁気として素子に真実を刻み込む儀式。
普段、フレームワークの向こう側で何気なく行われている db.save() や INSERT INTO の裏側では、ディスクヘッドの物理的な移動、OSのキャッシュとの駆け引き、そしてクラッシュに抗うアルゴリズムのドラマが繰り広げられています。
「メモリとファイル」という2つの道具の物理限界を知り、それらを巧みに編み合わせること。それこそが、すべての堅牢なソフトウェアシステムの根底を支えるエンジニアリングの神髄なのです。
📝 3行で頭に入る『試験・実務の要点まとめ』
- ランダムとシーケンシャルの物理差: ファイル途中への上書き(ランダムI/O)はヘッド移動やブロック消去で極端に遅いが、末尾追記(シーケンシャルI/O)ならディスクでもメモリに迫る高速書き込みが可能。
- WALとMemTableの役割分担: 書き込み時はまずディスク末尾にWAL(先行ログ)を追記して
fsyncで永続性を確保し、同時にメモリ上の辞書(MemTable)を更新することで、超高速な読み書きと耐障害性を両立する。 - 削除とコンパクションの正体: 追記型アーキテクチャでは削除は「墓石(Tombstone)」ログの追記で表現され、後からバックグラウンドのコンパクション(SSTable統合)によって物理的に重複データが掃除される。