後工程(アドバンスド・パッケージング)の逆襲
かつて半導体業界において、製造工程は残酷なまでの「身分制度」に分かれていました。
シリコンウエハの上に原子レベルの回路を焼き付ける「前工程(露光・成膜・エッチング)」は、巨額の設備投資と最先端物理が支配する花形舞台であり、そこで働く技術者は「エリート」と呼ばれました。 一方で、ウエハから四角いチップを切り出し、黒い樹脂で固めてプラスチックのゲタを履かせる「後工程(アセンブリ・パッケージング・テスト)」は、付加価値の低い「ただの箱詰め作業」と見下され、コストを削るために人件費の安いアジア諸国へ丸投げされるのが長年の常識でした。
しかし今、TSMCの決算会見でアナリストたちが血眼になって質問し、NVIDIAのジェンスン・フアンが生産増強を懇願しているのは、最新の露光装置の台数ではありません。 **「CoWoSをはじめとする後工程(アドバンスド・パッケージング)の生産ラインがどれだけ確保できるか」**です。
これまで軽視されていた後工程が、なぜ半導体の進化を牽引する絶対的な主戦場へと大逆転を遂げたのか? そこには、半導体を1枚の大きな板として作り続けることが不可能になった**「巨大チップの物理限界(モノリシックの死)」と、ミクロな部品を狂いなく切り出し、隙間なく樹脂で固める日本の超精密機械工学(東京精密、TOWA等)の執念**がありました。
1. 「モノリシックの死」とレチクル限界(チップを大きく作れない理由)
半導体の性能を最も手っ取り早く上げる方法はシンプルです。「チップの面積を大きくして、演算器(トランジスタ)をたくさん詰め込むこと」です。 従来は、CPUもGPUも、すべての回路を1枚の連続したシリコン片の上に一体成形する**「モノリシック(単一結晶)構造」**で作られていました。
しかし、この手法は2つの分厚い物理の壁に激突しました。
① レチクル限界(露光装置の物理的視野)
第5話で解説したEUVなどのフォトリソグラフィ露光装置には、光学レンズや反射ミラーの設計上、「一度に光を照射して焼き付けられる最大の面積(露光視野:レチクル限界)」が存在します。 業界標準のレチクルサイズは約858平方ミリメートル(約26mm × 33mm)。親指の爪より一回り大きい程度です。これ以上大きなチップは、光の枠からはみ出してしまうため、物理的に1回の露光で作ることができません。
② 面積の2乗で跳ね上がる「歩留まりの罠」
さらに過酷なのが、製造コストを支配する「歩留まり(良品率)」の数理モデルです。 ウエハの上には、どれほどクリーンルームを徹底しても、目に見えない微小な欠陥(パーティクル)が一定の密度でランダムに降り注ぎます。
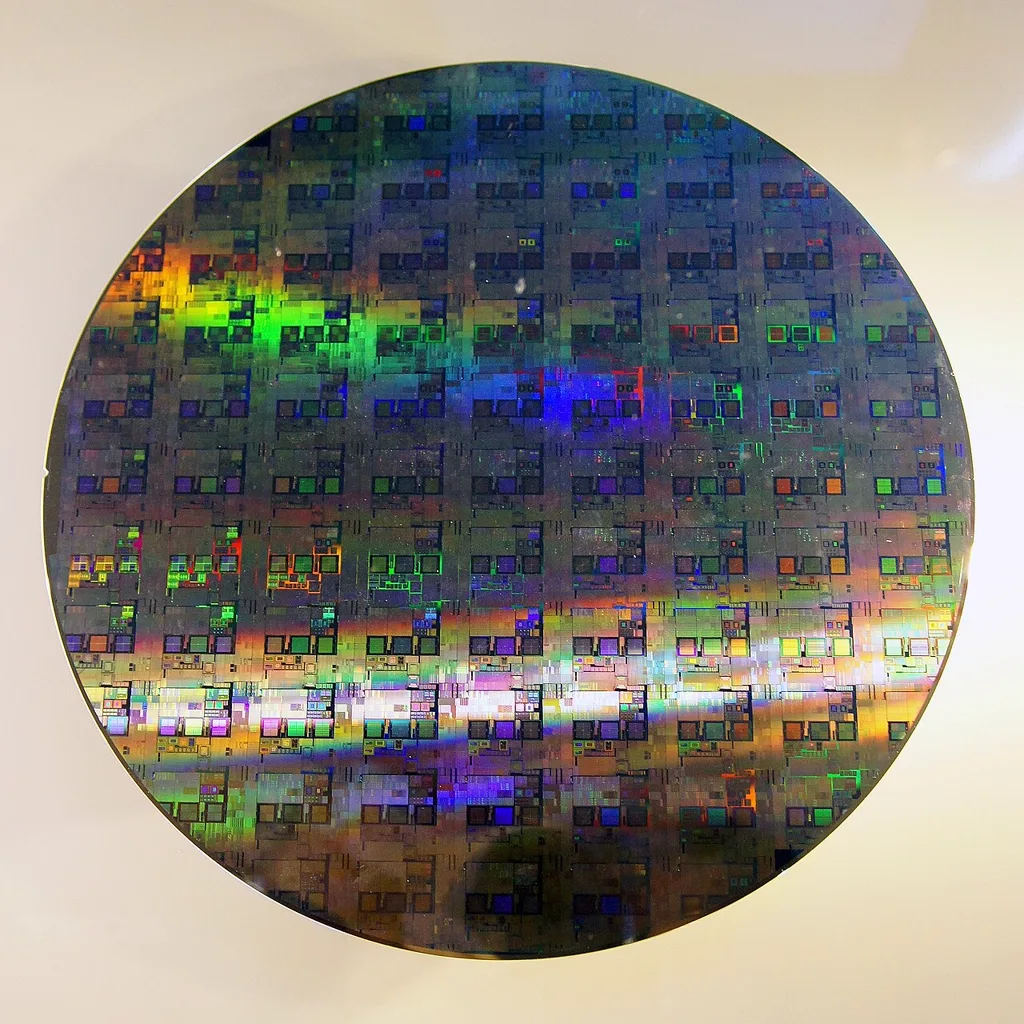

チップの面積が2倍になると、欠陥を踏み抜く確率は単純な2倍ではなく、指数関数的に跳ね上がります(マーフィの歩留まりモデル)。 最先端のプロセスノード(3nmなど)でレチクル限界スレスレの超巨大チップを作ろうとすれば、ウエハ1枚から取れる良品が数個、歩留まりが10〜20%にまで暴落し、チップ1個の製造原価が数百万円に跳ね上がってしまいます。1枚の大きなチップを作り続けるアプローチ(モノリシック)は、商業的にも物理的にも完全に死を迎えたのです。
触って試す:歩留まりの体験
📐 歩留まりシミュレータ(欠陥密度は一定)
ダイ(チップ1個)の大きさを選んでください。ウエハに降り注ぐ欠陥の密度が同じでも、面積の大きなダイほど欠陥を踏みやすくなり、歩留まり(良品率)が崩れていきます。
まずはダイの大きさを選んでみてください。
※ 試算は記事の説明に沿った簡易モデル(ポアソン型:歩留まり = e^(−面積×欠陥密度))による概算です。欠陥密度は 0.2 個/cm² で固定しています。実際の歩留まりは欠陥の分布や工程条件によって変わります。
2. チップレット思想:巨大都市を解体し、立体結合する
この限界を突破するために生まれたのが、**「チップレット(Chiplet)」**という革命的な設計思想です。
「作りにくい巨大な1枚のチップを作るのはやめよう。機能ごとに小さなブロック(チップレット)に分割して別々に製造し、最後にパズルのように完璧に繋ぎ合わせればいい」
チップレットの利点は、単なる歩留まり向上にとどまりません。**「適材適所のプロセスノード選択」**が可能になります。
最先端の3nmプロセスで微細化する恩恵が大きいのは、トランジスタが密集する「演算コア(ロジック)」だけです。外部と信号をやり取りする「I/O回路」や「アナログ回路」は、微細化しても回路が小さくならず、むしろノイズ耐性が悪化します。 ならば、演算コアだけを高価な最先端3nmで小さく作り、I/O回路は安価で実績のある6nmや7nmで作り、それらを後工程で1つのパッケージの上に高密度に並べればよいのです。
AMDのRyzen/EPYCプロセッサや、Intelの最新CPU、そしてNVIDIAの次世代GPU「Blackwell(B200:2つの超巨大ダイを10TB/sの超高速インターコネクトで繋いだチップ)」に至るまで、すべての最先端半導体は、このチップレット技術なしには成立しなくなっています。
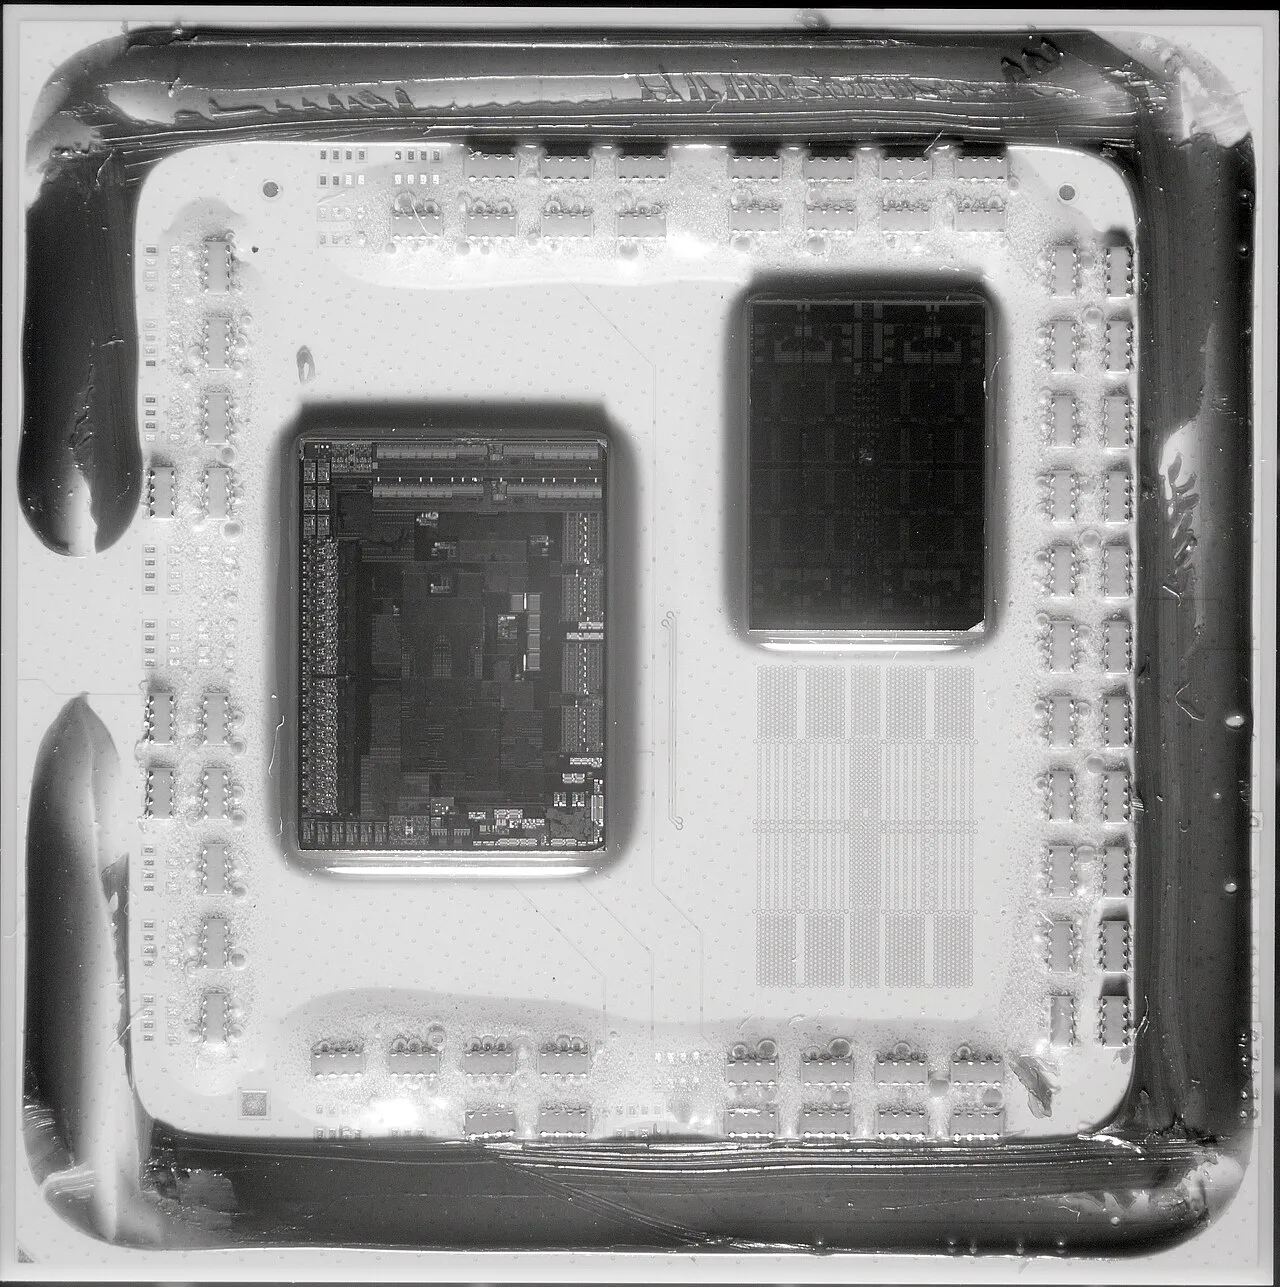

そして、この「バラバラに作った小さなチップたちを、ナノ単位の精度で隙間なく平坦に結合する」作業こそが、アドバンスド・パッケージングの正体です。
3. 切断と選別の物理:東京精密(プロービングとダイシングの極限)
チップレット構造を採用したことで、後工程には**「絶対に失敗が許されない過酷な関門」が生まれました。 それが、「KGD(Known Good Die:完全良品ベアダイ)」**の選別です。
もし、8個のチップレットを組み合わせて1個の高級AIプロセッサを作る場合、そのうちのたった1個に不良品が混ざっていたらどうなるでしょうか? 完成した巨大パッケージは一切動かず、残り7個の完璧な良品チップも、高価なHBMも、すべて道連れにしてゴミ箱行きになります。 そのため、チップをパッケージに載せる前、ウエハの段階で「どのチップが100%完璧に動くか」を極限の精度で選別し、1マイクロメートルの狂いもなく切り離さなければなりません。
ここで世界を支配しているのが、日本の**東京精密(Tokyo Seimitsu)**などの精密計測・加工技術です。
サブマイクロメートルの針当て:ウエハプローバ
ウエハプローバとは、ウエハ上に作られた数千〜数万個の極小電極パッドに、針(プローブカード)を正確に押し当てて電気的特性を検査する装置です。
最先端チップの電極パッドの間隔は、わずか数十マイクロメートル。少しでも位置がズレれば、隣の端子とショートして回路が吹き飛びます。 さらに、シリコンの表面は空気中の酸素に触れて「電気を通さない強固な酸化膜(SiO2)」で覆われています。プローバは、針を電極にただ乗せるだけでなく、**「数マイクロメートルだけ針の先端を横に滑らせて酸化膜を削り剥がし(スクラブ動作)、電極を傷つけない絶妙な力加減で通電させる」**という、神業のようなナノ位置決め制御を毎秒繰り返します。
割らずに切り離す:ダイシングの力学
良品を選別したあとは、ウエハを四角いサイコロ状に切り出す「ダイシング」です。

第2話で触れたように、最新の積層半導体に使われるウエハは、裏面を研削されて**厚さ数十マイクロメートル(サランラップ並みの薄さ)**にまで削り落とされています。 これを従来のダイヤモンド回転刃(ブレード)で乱暴に切断すれば、刃の振動でシリコンの端に微小なヒビや欠け(チッピング)が入り、チップは真っ二つに割れてしまいます。
現在では、ウエハの内部に赤外線レーザーを集光させ、シリコンの分子結合を内部から破壊して改質層を作り、ウエハを貼り付けたシートを外側に引っ張ることで綺麗に割断する**「ステルスダイシング」や、プラズマガスで化学的にエッチングして溝を掘り抜く「プラズマダイシング」**といった極限の物理工法が駆使されています。
4. 隙間なく埋める流体力学:TOWAのコンプレッション・モールディング
無傷で切り出された良品チップレットとHBMは、シリコンインターポーザーの上に並べられ、数万本のマイクロバンプで電気的に結合されます。 しかし、これで終わりではありません。剥き出しのシリコンは極めて脆く、大気中の湿気や熱ストレスで簡単に死に至ります。 チップ群を保護するため、熱伝導性に優れたエポキシ樹脂(封止材)を流し込み、カチカチのブロックに固める**「モールディング(封止工程)」**が必要です。
ここで半導体業界の前に立ちはだかったのが、流体力学の壁でした。
従来の「トランスファーモールド」の限界
これまでの封止技術は、金型の中にチップを置き、熱でドロドロに溶かした液状樹脂を横の注入口から強い圧力で押し込む**「トランスファー方式(射出成形)」**でした。たい焼き器の端からあんこを勢いよく流し込むようなイメージです。
しかし、アドバンスド・パッケージングの世界では、この方式は破綻しました。 チップとチップの隙間はわずか数マイクロメートル、下部には無数の繊細なマイクロバンプが林立しています。 横からドロドロの樹脂を高圧で流し込むと、以下のような致命的な事故が多発したのです。
- ワイヤー流れ・バンプ破壊:樹脂の流動圧力に押され、細い金属配線がなぎ倒されてショートする。
- 気泡(ボイド)の残留:狭い隙間に樹脂が回り込む前に空気が閉じ込められ、気泡が残る。熱がかかったときにこの気泡が膨張し、チップを内部から爆破する。
- 未充填:樹脂の粘度が高すぎて、奥の狭い隙間まで到達しない。
TOWAが発明した「コンプレッション・モールディング(圧縮成形)」
この絶望的なボトルネックを打ち破り、世界のAI半導体パッケージングを独占したのが、京都に本社を置くTOWAです。
TOWAは、横から樹脂を力任せに流し込むのを完全にやめました。 **「あらかじめ下側の金型に、溶かした樹脂(または微細な顆粒樹脂)を満遍なくプールのように敷き詰めておき、その上からチップが並んだウエハ全体を、真空チャンバーの中で静かにプレスして沈め込む」という「コンプレッション・モールディング(圧縮成形)」**を発明したのです。
この工法の物理的優位性は圧倒的でした。
- 流動ストレスがほぼゼロ:樹脂が横方向に激しく流れないため、髪の毛より細い配線や微細バンプに一切の横圧力がかからない。
- 完全なボイドレス(気泡ゼロ):真空中で垂直に押し固めるため、空気が巻き込まれる余地がない。
- 超大型基板への対応:大口径300mmウエハや、さらには巨大な四角いガラス基板(パネルレベルパッケージ)であっても、均一な厚みで歪みなく一発で封止できる。
HBMの多層積層や、TSMCのCoWoSプロセスにおいて、TOWAのコンプレッション・モールディング装置は世界シェアの大半を握る絶対的なデファクトスタンダードとなっています。 どんなに精密な半導体回路を作っても、最後の封止でTOWAの機械がなければ、熱と衝撃に耐えうる製品として世に出荷することはできないのです。
結論:半導体の最前線は「前工程」から「立体結合の工学」へ
半導体の歴史とは、長らく「いかにシリコンの上に小さな絵を描くか」という平坦な2次元の解像度競争でした。 しかし、原子の限界とコストの壁がモノリシックの限界を告げた今、進化のバトンは完全に**「バラバラのチップを、いかにナノの狂いもなく切り出し、並べ、立体的にパッケージングするか」**という後工程へと渡されました。
露光機でどれほど微細な回路を焼き付けても、
- 東京精密の超精密位置決めがなければ、良品チップを選別して切り出すことができず、
- 第4話の味の素のABF基板がなければチップ同士を配線できず、
- TOWAの真空圧縮成形がなければ、ナノの隙間を埋めて製品を保護することすらできません。
「前工程」と「後工程」の境界線は完全に消滅しました。 これからの半導体覇権は、光で回路を刻む力だけでなく、物理的な物質と熱、流体をミクロの極限でコントロールする日本の精密機械・材料工学と完全に一体不可分なものとして進化していくのです。
📝 3行で頭に入る『試験・実務・投資の要点まとめ』
- 【モノリシックの限界】 露光装置のレチクル枠(約858mm²)と面積の2乗で悪化する歩留まりの壁により、1枚の巨大チップを作る時代は終わり、小チップを繋ぐ「チップレット」が必須となった。
- 【選別と切断の物理】 1個の不良品が全滅を招くチップレットでは、ウエハ段階でサブμmの針当てを行うプローバや、割れ・欠けを防ぐダイシング技術(東京精密等)が死活問題となる。
- 【封止の覇者TOWA】 高圧で樹脂を流す従来法を捨て、真空中で静かに押し固める「コンプレッション・モールディング」を開発。横圧力をゼロにし、気泡のない超精密封止で世界を独占している。