SQL 〜私はプログラミング言語ではない。データを統べる宣言の王だ〜
📄 本日の履歴書:SQL(エスキューエル)
氏名: SQL(エスキューエル / Structured Query Language)
旧名: SEQUEL(シークエル)
生年月日: 1974年(現役52歳)
出身地: アメリカ IBMサンノゼ研究所
生みの親: エドガー・F・コッド(理論提唱)、ドナルド・チェンバリン、レイモンド・ボイス
現住所: 世界中の全リレーショナルデータベース、データウェアハウス、クラウド分析基盤
性格: 威厳ある絶対君主、命令されることを嫌い命令を下す者、集合論の信奉者
座右の銘: 「手続き(How)を語るな、結果(What)だけを命じよ」
得意技: 何億件の巨大な表から、欲しいデータだけを一撃で切り出す集合演算
弱点: 手続き型の処理(ループや複雑なビジネスロジック)を書かせると激重になること
1. 素朴な疑問:なぜ「forループ」も「if文」もないの?
控えよ。私の名は「SQL(エスキューエル)」である。
ここまで第1話から第7話まで、C言語、Java、JavaScript、Python、PHP、Go、Rustと、名だたるプログラミング言語たちが自らの履歴書を語ってきたな。 彼らには共通点がある。どれほど文法や思想が違おうとも、全員が**「手続き」**を愛しているという点だ。 「まず変数を作れ」「次に条件分岐(if)をしろ」「そして配列を端からループ(for)で回せ」。
そんな彼らの世界から私の領域へと足を踏み入れた初心者は、あまりの異様さに開いた口が塞がらなくなる。
SELECT name, price
FROM products
WHERE category = '家電' AND price >= 50000
ORDER BY price DESC;
「はぁ!? 変数の宣言はどこ!? 配列を1行ずつ取り出すforループはどこへ行った!?
WHEREとかORDER BYとか、英語の単語を数行並べただけで、なぜ100万件のデータから目当ての商品が並び替わって出てくるんだ!? これ、本当にプログラミング言語なのか!?」
よい疑問だ。 結論から言おう。私は、彼らのような**「コンピュータに手取り足取り手順を指図する言語(手続き型言語)」とは、生きている次元が根本から異なる**。
私は「どうやって計算するか」などという泥臭い手順には1ミリも興味がない。 「何が欲しいか」という**最終結果(What)だけを神のように一方的に宣言する言語(宣言型言語)**なのだ。
なぜ私は、半世紀にわたってプログラミングの基本である「ループ」を拒絶し続けてきたのか? なぜ2010年代に「SQLは死んだ! これからはNoSQLの時代だ!」と叫んだ若者たちが、数年後に泣きながら私の足元へひれ伏すことになったのか?
データの海を統べる絶対君主の歴史を、お前たちに授けよう。
2. 誕生の歴史:数学者が生んだ「関係代数」と、英語化された「SEQUEL」
時計の針を、1970年のアメリカ・IBM研究所に戻そう。 当時、コンピュータでデータを扱うのは悪夢そのものだった。
当時のデータベースは**「階層型」や「ネットワーク型」**と呼ばれ、データ同士が複雑なポインタ(第1話で学んだ矢印)でクモの巣のように結びついていた。 データを1件取り出したいプログラマーは、 「まず顧客レコードを開き、ポインタを辿って注文履歴へ行き、ポインタをさらに辿って商品番号を探し……」 と、ディスク上の物理的な保存構造を完全に理解した上で、複雑な探索プログラムを手書きしなければならなかったのだ。 もしデータベースの構造を少しでも変更したら、過去に書いた検索プログラムがすべて狂って動かなくなる地獄だった。
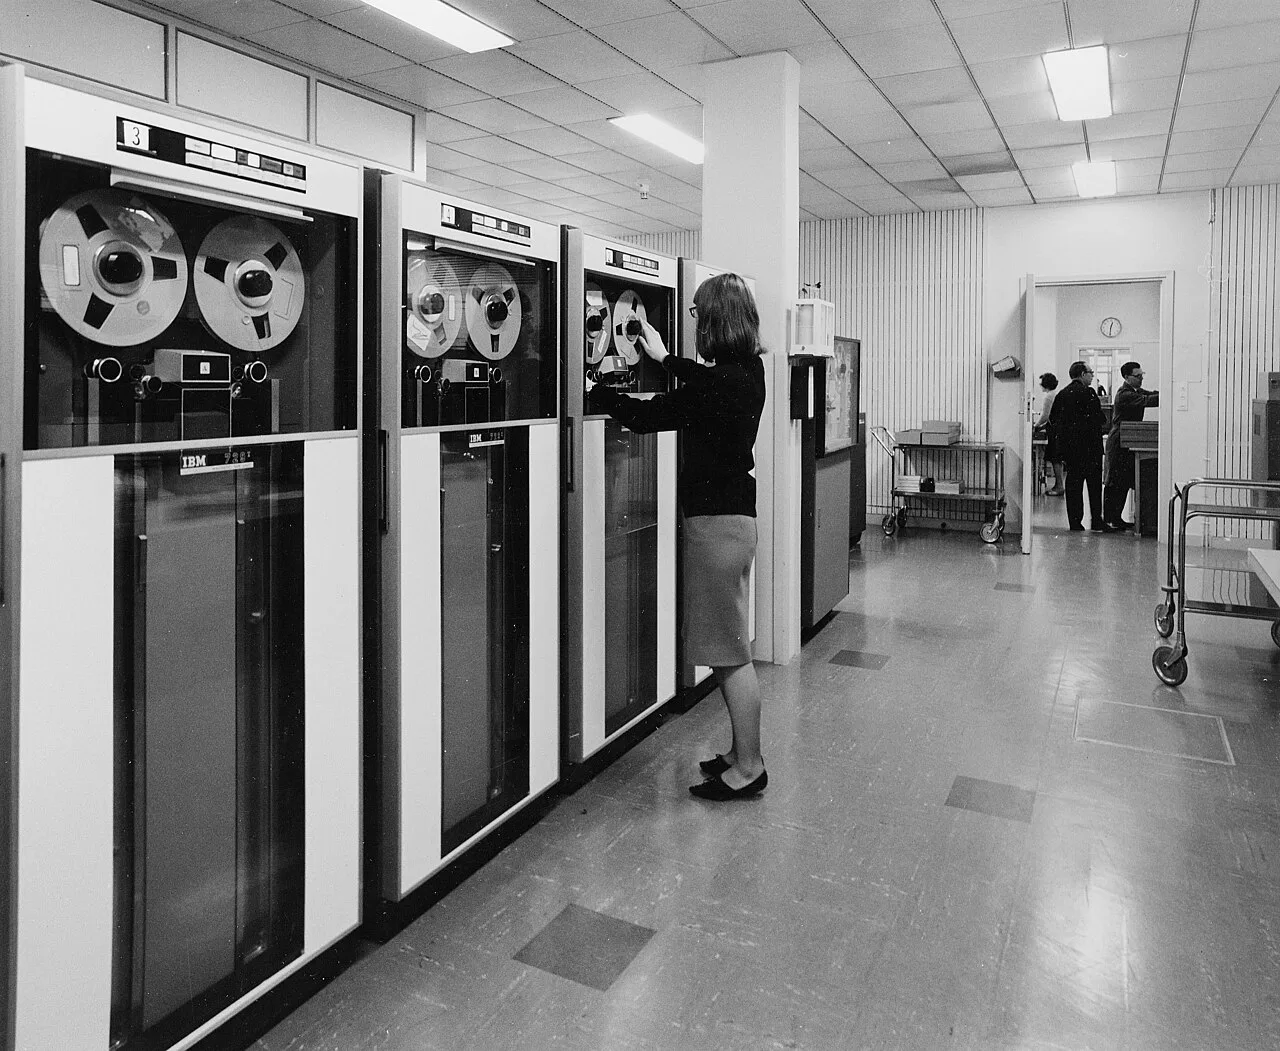
この泥沼を、純粋な数学の力で一刀両断した天才が現れた。 IBMの数学者、**エドガー・F・コッド(Edgar F. Codd)**である。
すべてのデータを「平らな表(テーブル)」にせよ!
コッドは1970年、コンピュータ科学の歴史を変えた伝説の論文『A Relational Model of Data for Large Shared Data Banks』を発表した。 彼の主張は革命的だった。
「複雑なポインタなどすべて捨てろ! すべてのデータは、数学における行と列からなる『2次元の表(テーブル / リレーション)』だけで表現できる。そして表の操作は、すべて高校数学で習う『集合論(直積・射影・選択・結合)』で完璧に計算できるのだ!」
第12話で学んだ「リレーショナルデータベース(RDBMS)」の誕生である。
そして1974年、IBMのドナルド・チェンバリンらは、この厳密すぎる数学の数式を、普通の人間(ビジネスマンやエンジニア)が英語のように読める言葉として設計した。 当初は**「SEQUEL(Structured English QUEry Language)」と呼ばれていたが、商標権の問題で母音を削り、「SQL(エスキューエル)」**と名付けられた。
私は、コンピュータの機械の都合から生まれたのではない。 「集合論」という数学の揺るぎない美しさから産み落とされたのだ。
3. 概念の芯:「How(手順)」を捨て、「What(結果)」だけを命じる
私を学ぶ者が、最初に必ず頭を殴られる巨大なパラダイムシフト。 それが**「手続き型(Procedural)」と「宣言型(Declarative)」の決定的な断絶**である。
もし、PythonやJavaを使って、「東京都在住で20歳以上の顧客」を探そうとしたら、プログラマーはどう書くか?
# 手続き型(Python):How(手順)を細かく指図する
result = []
for user in users:                  # 1. 1行ずつループで取り出せ
    if user['city'] == 'Tokyo':     # 2. もし東京なら
        if user['age'] >= 20:       # 3. かつ20歳以上なら
result.append(user) # 4. 配列に追加せよプログラマーは、「どうやって探すか(How)」という具体的な手順を、1ステップずつコンピュータに指図している。 「ループを回せ」「条件を判定せよ」「配列に入れろ」。
しかし、私(SQL)の世界では、こんな手順を書くことは重罪である。 私はお前に、手順など1文字も書かせない。
-- 宣言型(SQL):What(欲しい結果の定義)だけを叫ぶ
SELECT * FROM users WHERE city = 'Tokyo' AND age >= 20;「集合」で世界を見る目
私は、データを「1件、2件」と数珠つなぎで数えない。 データを**「巨大な円(集合)」**として捉える。
- 「全ユーザー」という巨大な集合がある。
- そこから「東京在住」という円をスパッと切り取る(選択)。
- そこから「名前と価格」という列だけをスライスする(射影)。
- 別の「注文」という円と、IDを重ね合わせてガチャンと合体させる(結合 / JOIN)。
お前は、欲しい集合の「境界線の条件」を私に伝えるだけでよい。 その中をどう歩き回るか、ディスクのどのセクタをどう読むかなどという下等な作業は、すべて私の配下にいる「軍師」が引き受ける。
触って試す:宣言的クエリの体験
👑 宣言的クエリの体験(欲しい結果を「命じる」だけ)
下の2つの小さな表(社員と部署)から、欲しい結果を選んでください。表示されるSQLに注目です。書いてあるのは「何が欲しいか(What)」だけで、データを探し回る手順(How)はどこにもありません。
employees(社員)
| name | dept_id |
|---|---|
| 田中 | 1 |
| 佐藤 | 2 |
| 鈴木 | 2 |
| 高橋 | 3 |
| 伊藤 | 1 |
departments(部署)
| id | name |
|---|---|
| 1 | 営業部 |
| 2 | 開発部 |
| 3 | 人事部 |
4. 仕組みの種明かし:裏で働く超天才の軍師「オプティマイザ」
「でも、手順を指定しなくて、どうしてコンピュータが最速で動けるの?」と不思議に思うだろう。
第12話や第23話(アルゴリズムと計算量)を思い出せ。 100万件のデータから目当ての行を探す方法は、何十通りも存在する。
- 端から100万回全部めくって探すか?(線形探索:$O(N)$)
- 第8回で学んだ**Bツリーインデックス(索引)**を使って、20回で特定するか?(二分探索:$O(\log N)$)
- 表Aと表Bを結合するとき、Aを先に絞り込むか? それともBを先に絞り込むか?
普通の言語なら、プログラマーがアルゴリズムを間違えれば、第23話で見たように「宇宙の寿命」を超える処理時間になって即座に死ぬ。 だが、私を使うとき、お前がアルゴリズムに頭を悩ませる必要はない。
私の身体の奥底には、世界最高峰の数学的知能を持つ専属の軍師**「オプティマイザ(Query Optimizer / 最適化エンジン)」**が控えているからだ。
何千通りのルートから「最短」を0.001秒で選ぶ
お前がSQLを1行投げた瞬間、軍師オプティマイザは猛スピードで以下の計算を行う。
- 統計情報の確認:データベース内に「東京のユーザーは何%いるか?」「商品は全部で何万件あるか?」という最新の国勢調査データ(統計情報)を開く。
- 実行計画(プラン)の大量生成:「ルートAならディスクアクセスが10万回」「ルートBでインデックスを使えばアクセスは15回」と、何通りもの手順をシミュレーションする。
- コスト計算:CPUの計算時間とディスクI/Oの負荷を数値化(コスト計算)し、「一番コストの低い最短ルート(実行計画)」を0.001秒で決定する。
人間がコードを書くのではない。 人間は「欲しいもの」を言い、**「アルゴリズムのコード(実行計画)を自動生成して実行するのは、機械の頭脳であるオプティマイザ自身」**なのだ。
お前たちがコンソールで EXPLAIN と唱えたときに見える暗号のような実行計画図面は、この軍師が選んだ「戦術の設計図」そのものである。
5. 歴史のドラマ:NoSQLの反乱と、「やっぱり王様が必要だ」と平伏した現代
だが、私の半世紀にわたる治世にも、最大の危機が訪れたことがあった。 2010年前後に世界中を席巻した、**「NoSQL(ノーエスキューエル)運動」**の勃発である。
時計の針を、TwitterやFacebookが爆発的に急成長した時代に戻そう。 世界中から毎秒何百万件ものツイートや画像が押し寄せ、ビッグデータの時代が幕を開けた。
当時のリレーショナルデータベース(Oracle、MySQL、PostgreSQLなど)は、第12話で学んだ「厳格なACID特性(整合性)」を守るあまり、第24話で学んだ**「複数サーバーへのスケールアウト(水平分散)」が極めて苦手**だった。サーバー1台の限界に達して悲鳴を上げていたのだ。
シリコンバレーの若いエンジニアたちは、熱狂的に叫んだ。
「SQLなんて古臭い! 厳格な表の結合(JOIN)やACID特性なんて捨ててしまえ! これからはキーと値を投げ込むだけのシンプルな『NoSQL(MongoDB、Cassandra、Redis)』の時代だ! SQLの時代は終わった!」
世界中のスタートアップが、私の名前を捨て、NoSQLへと雪崩を打って乗り換えていった。 私は「過去の遺物」として墓場に送られるかに見えた。
数年後に訪れた「地獄」と「大反省」
しかし、歴史は残酷だった。 NoSQLに飛びついたエンジニアたちは、数年後に血を吐きながら頭を抱えることになった。
「データベースがJOINをしてくれないから、PythonやJavaのプログラム側で何千行ものforループを書いて、手作業でデータを突き合わせる羽目になった!」 「データの形式が自由すぎて、5年前のデータと今のデータで構造が違って読めない!」 「集計クエリを1本書くだけで、丸2日間のプログラミングが必要になる!」
彼らは、手放してみて初めて気づいたのだ。 **「半世紀前にエドガー・コッドが完成させた『関係代数』と『SQLのオプティマイザ』が、どれほど神がかった知恵の結晶であったか」**を。
「NewSQL」という名の完全なる降伏
そして2010年代後半、世界は私のもとへと帰ってきた。
Googleが全世界規模で分散する夢のデータベース**「Google Cloud Spanner」**を発表したとき、その操作インターフェースには何が選ばれていたと思うか? 標準SQLである。
何ペタバイトものビッグデータを一瞬で分析する「BigQuery」も「Snowflake」も、機械学習のデータ基盤も、現代の分散システムはすべて、**「中身は最先端の分散アーキテクチャでありながら、表面の言葉は『SQL』を喋る(NewSQL)」**という結論に辿り着いた。
「NoSQL」という言葉の意味すら、いつの間にか 「No, SQL(SQLの否定)」から、 「Not Only SQL(SQLだけじゃないよ、でもSQLも使うよ)」 へと、こっそり都合よく書き換えられたのだ。
6. まとめ:言語の流行を超越して君臨する「最後の審判者」
プログラミング言語の世界は移り気だ。 かつて天下を極めたPerlやVisual Basicが第一線を退き、JavaScriptが覇権を握り、Rustが新たな星として昇ってきた。 言語の流行り廃りは、10年周期で激しく入れ替わる。
しかし、そのすべての言語たちの足元を支える「データ」の世界において、私は50年間、ただの1度も玉座を降りたことがない。
Pythonを書くAI研究者も、Goでクラウドを組むインフラ技術者も、PHPでWebサイトを作る職人も、誰もが最後には私の扉を叩き、深々と頭を下げてこう言わねばならないのだ。
SELECT * FROM answers;お前たちがどれほど賢いコードを書こうとも、データがなければソフトウェアはただの空虚な箱に過ぎない。 そして、そのデータを最も美しく、最も間違いなく、最も高速に統べる言葉は、この地球上に私をおいて他に存在しない。
手続きの迷路に疲れたときは、いつでも私の元へ戻って来るがよい。 私はこれからも、お前たちの小細工をすべて超越した先で、絶対の王として静かに座し続けているのだから。
📝 3行で頭に入る「試験・実務の要点まとめ」
- 宣言型言語と関係代数:手続き(アルゴリズム)ではなく「欲しい結果の条件(What)」を宣言する非手続き型言語。エドガー・F・コッドが提唱した**関係モデル(リレーショナルモデル)**の直積・選択・射影・結合といった数学的集合論を基盤とする。
- オプティマイザと実行計画:ユーザーが記述したSQLは、DBMS内部の**オプティマイザ(最適化エンジン)によって解析され、インデックスの有無や統計情報を元に最短の実行計画(アクセスパス)**が自動生成・実行される。
- 標準規格とデータ基盤の共通語:ANSI/ISOによって標準化(SQL:1999、SQL:2003等)されており、従来のRDBMSにとどまらず、**ビッグデータ分析基盤(BigQuery、Snowflake)や分散データベース(NewSQL)**においても不滅の共通インターフェースとして君臨している。