エッジAIと「ユニファイドメモリ・帯域幅」の戦い
近年、AI開発者やギークたちの間で、ある奇妙な逆転現象が話題を集めています。
何十万円もかけて最新の超高性能デスクトップPC(水冷CPU、ハイエンドな外付けグラフィックボード、大容量64GBメモリ)を組み上げたエンジニアが、手元のPCで700億パラメータ級の大規模言語モデル(70BクラスのローカルLLM)を動かそうとした瞬間、「CUDA Out of Memory(メモリ不足)」のエラーで即座にクラッシュします。 パラメータを無理やりメインメモリ(RAM)に逃がして動かしても、文字の出力速度は1秒に1文字(1〜2トークン/秒)というカタツムリのような遅さに成り果てます。
その一方で、机の片隅に置かれた、手のひらサイズでファンも静かに回るMac miniやMac Studioの上で、同じ巨大なAIモデルが1秒間に数十文字(20〜30トークン/秒)という信じられないスピードで滑らかに文章を紡ぎ出しているのです。
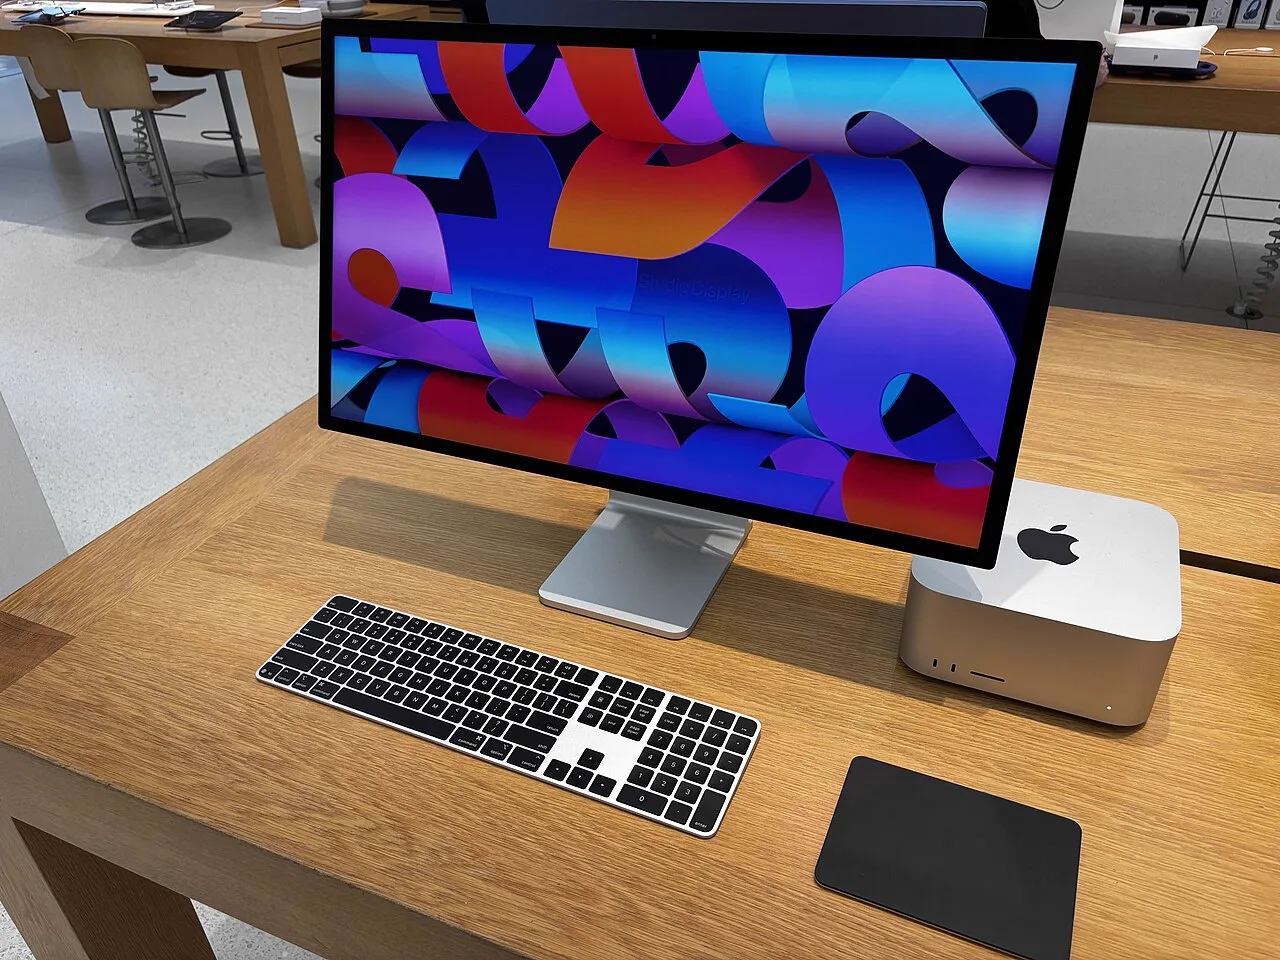

「なぜ、消費電力も冷却ファンも圧倒的に巨大なゲーミングPCが敗北し、板チョコのように小さなMacが笑うのか?」
その秘密は、GPUの計算力(FLOPS)でもCPUのクロック周波数でもありません。 エッジ(端末側)でAIを動かすときに立ちはだかる絶対的な物理法則――**「メモリバス帯域幅(通り道の太さ)」と、CPU・GPUの物理配置をめぐる「ユニファイドメモリアーキテクチャ(UMA)」**の構造差にあります。
1. 算数で暴く:なぜLLMの推論速度は「帯域幅」で100%決まるのか?
ローカルLLMを動かすとき、多くの人は「GPUのCUDAコア数」や「Tensorコアの数」を気にします。 しかし、第2話のHBMでも触れた通り、「AIの推論処理(テキスト生成)」は、計算能力がボトルネックになることは滅多にありません。
ChatGPTをはじめとする自己回帰型(Autoregressive)のLLMは、文章を一気に生成するのではなく、**「1文字(1トークン)を出力するたびに、モデルの全重みパラメータをメモリから演算器へ丸ごと読み出す」**という狂気の力業を繰り返しています。
1文字出すために「40GB」を丸呑みする
具体例として、現在ローカルで極めて人気のある「70B(700億パラメータ)」モデルを、4ビット量子化(Q4)して動かすケースを計算してみましょう。
- モデルのデータサイズ:約40ギガバイト(GB)
- 1トークン生成に必要なデータ移動量:40ギガバイト(GB)
つまり、AIがたった1文字(1トークン)を画面に表示するためだけに、40GBもの膨大なデータをメモリからプロセッサの胃袋へ全部流し込まなければならないのです。 この物理法則から、LLMの理論上の最大推論速度(トークン/秒)を導き出す公式は、驚くほど単純な「小学生の割り算」になります。
$$ \text{推論速度 (Tokens/s)} \approx \frac{\text{メモリバス帯域幅 (GB/s)}}{\text{モデルのファイルサイズ (GB)}} $$
この式こそが、エッジAIのすべてを支配する絶対の神託です。 プロセッサの計算速度が光の速さであっても、「メモリからデータを吸い出す蛇口の太さ(帯域幅)」が、出力速度の上限を物理的に100%拘束します。
触って試す:推論速度の試算
🧮 推論速度の試算(帯域幅 ÷ モデルサイズ)
モデルと「通り道(メモリ帯域)」を選ぶと、記事の公式で理論上の推論速度を計算します。計算能力(FLOPS)は一切関係しません。
2. 分断された大陸:Windows/x86の「PCIeバス」という関所
では、なぜ一般的なWindowsやLinuxの自作PC・ワークステーションは、このエッジAIの計算で苦境に立たされるのでしょうか? 原因は、長年続いてきた**「マザーボードとPCIeバスの伝統的な物理構造」**にあります。
2つのメモリ、1本の細い橋
一般的なPCの中には、完全に独立した「2つの世界(大陸)」が存在します。
- システムメインメモリ(DDR5): マザーボードのスロットに挿すメモリ。64GBや128GBといった大容量を数万円で安価に手に入れられるが、バス幅が狭く(128bit程度)、帯域幅は「秒間60〜80GB/s」程度と非常にのろま。
- GPU専用メモリ(VRAM / GDDR6X): グラフィックボード上に直付けされたメモリ。バス幅を広げて周波数を極限まで高めており、**帯域幅は「秒間1,000GB/s(1TB/s)」**という猛スピードを誇る。
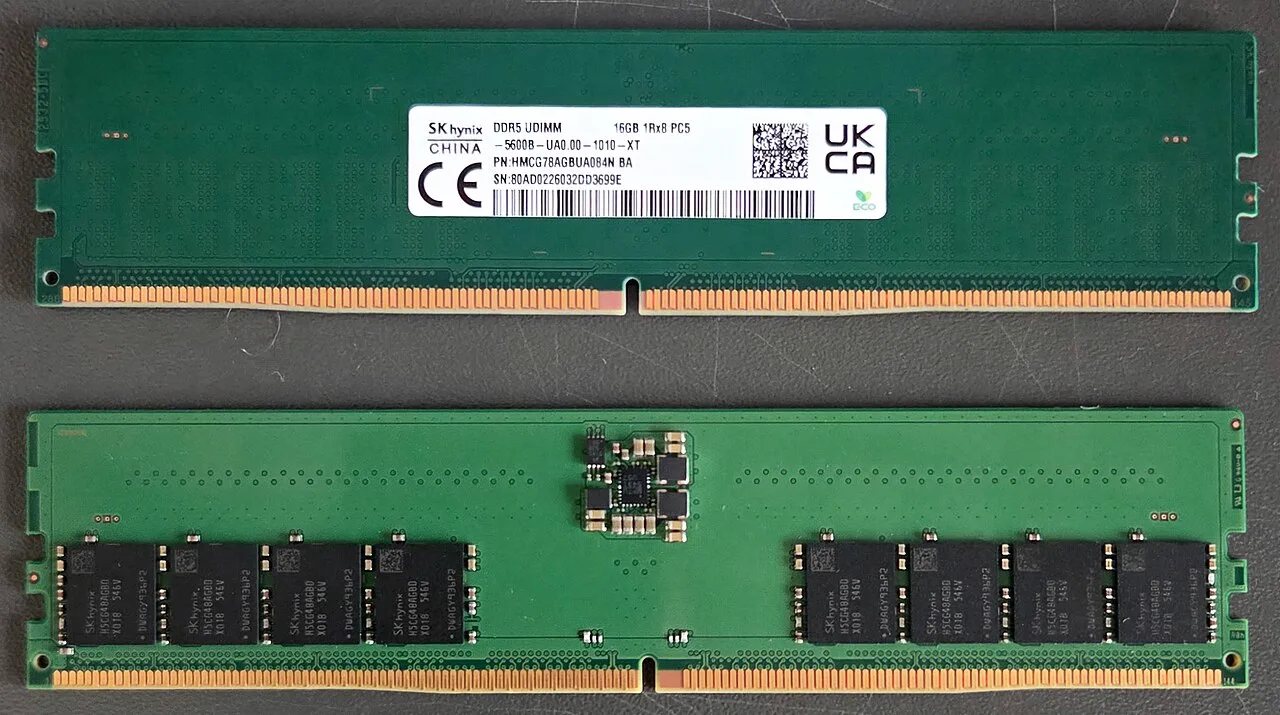

一見、GPUのVRAMは理想的に見えます。しかし、そこには残酷な**「容量の壁」があります。 コンシューマー向けの最高峰GPU(GeForce RTX 4090など)であっても、搭載されているVRAMは最大で「24GB」**しかありません。 先ほどの40GBある70Bモデルを動かそうとすれば、24GBの枠から16GB以上も溢れ出してしまいます。
PCIeという関所で起きる「地獄の玉突き事故」
VRAMから溢れたデータは、システム側のDRAMに逃がすしかありません(いわゆるCPUオフロード)。 しかし、GPUがシステムDRAMにあるデータを取りに行くには、マザーボードのスロットである**「PCIeバス」**を渡らなければなりません。
PCIe 4.0 x16の実行帯域幅は、**わずか「32GB/s(片道)」**です。 1,000GB/sで走っていたGPUの足元に、突如として32GB/sの極細ボトルネックが突きつけられます。さらに、CPU側とGPU側で同じデータを重複してコピーし合う無駄なオーバーヘッド(メモリの二重占有)も発生します。
結果として、先ほどの公式に当てはめると、全体のデータ転送速度は最も遅いPCIeバスに引っ張られて数GB〜十数GB/sにまで急落します。
$$ \frac{32 \text{ GB/s}}{40 \text{ GB}} \approx 0.8 \text{ Tokens/s} $$
1文字出すのに1秒以上待たされる、実用不能な「地獄の紙芝居」の完成です。 どれほど高額なグラフィックボードを積んでいても、「VRAMの容量という物理的な崖」を一歩でも踏み外した瞬間、PC全体のパフォーマンスは崖底へと叩き落とされるのです。
3. 統合の勝利:Appleシリコンの「ユニファイドメモリ(UMA)」
この分断のボトルネックを、物理レイアウトの完全な再定義によって打ち破ったのが、Appleの「Mシリーズ(Apple Silicon)」が採用した**「ユニファイドメモリアーキテクチャ(UMA:Unified Memory Architecture)」**です。
チップのすぐ隣に「巨大な共有プール」を直結する
Appleシリコンのパッケージを開口すると、中央に巨大なSoCダイ(CPU、GPU、NPUがワンチップに集約されたシリコン)があり、その真横のミリ単位の至近距離に、LPDDR5メモリのチップが直接並んでハンダ付けされています。
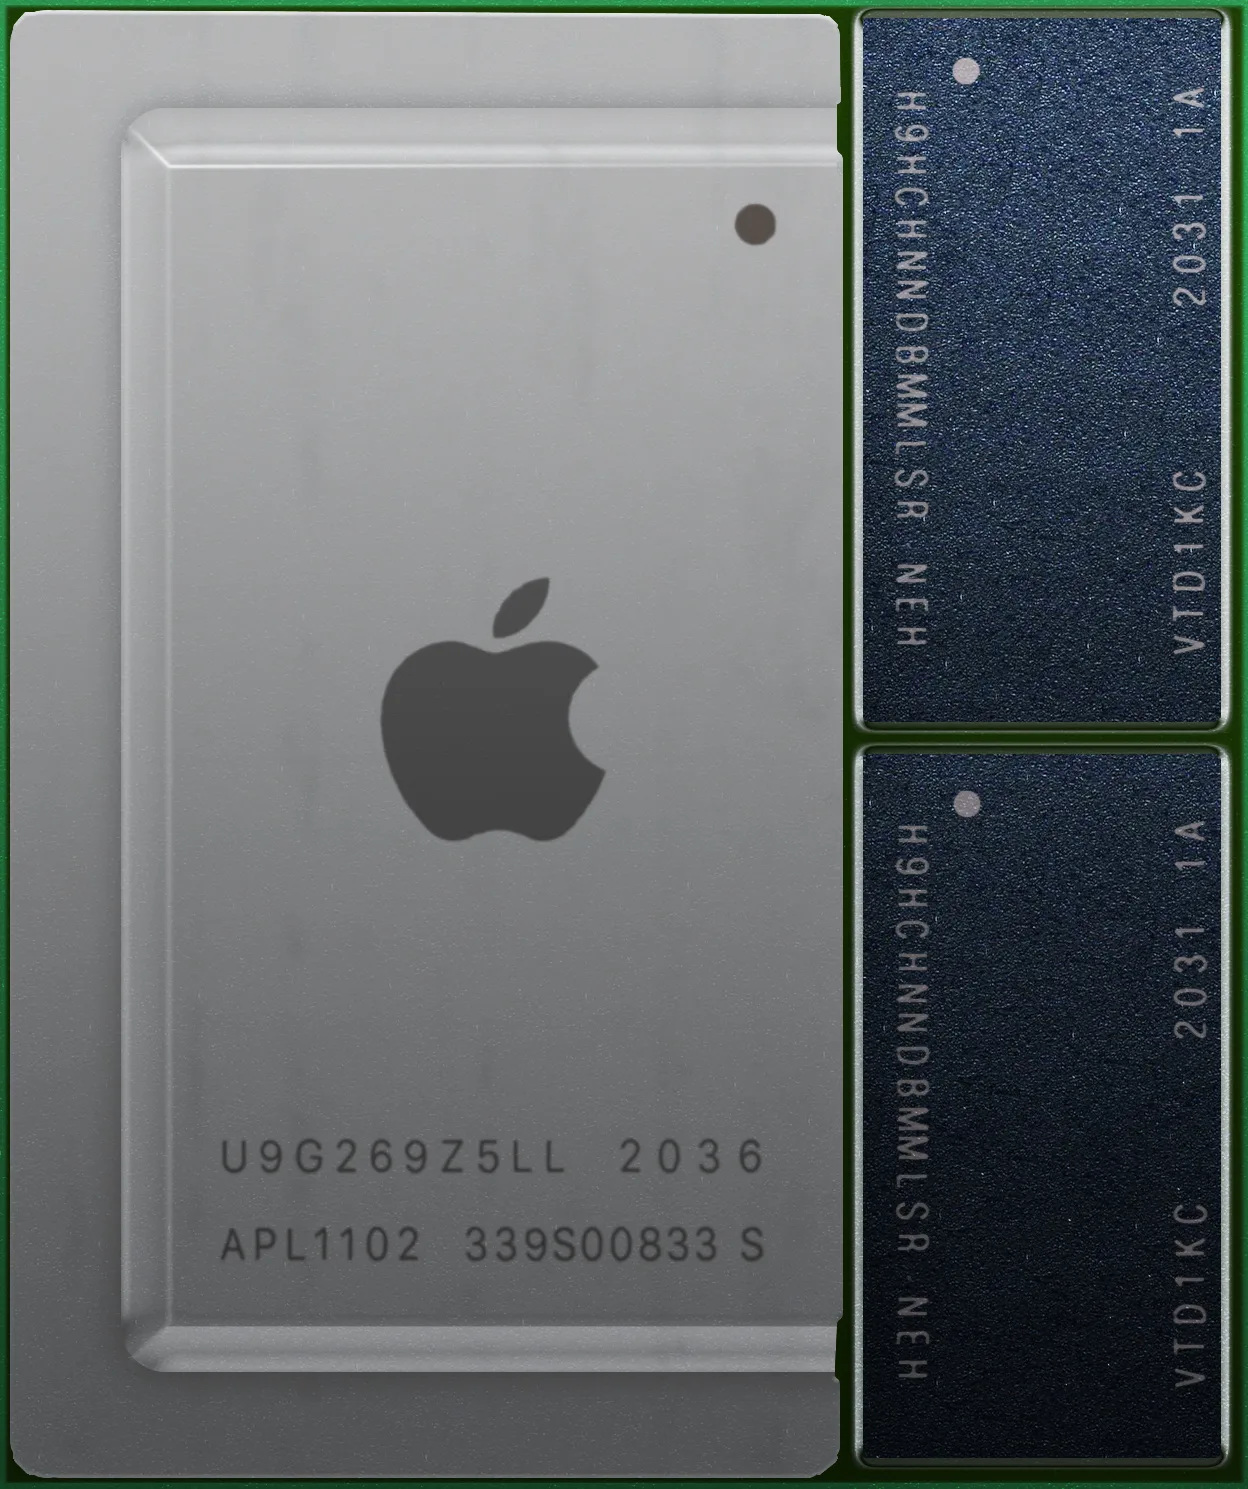

Appleのアプローチの革新性は、以下の3点に集約されます。
- メモリを全員で完全に共有する(ゼロコピー): 「CPU用メモリ」と「GPU用メモリ」という区別を物理的に全廃しました。巨大なメモリ空間を1つのプールとして全員が共有します。CPUが読み込んだAIモデルのデータを、GPUに「PCIe経由で転送」する必要は一切ありません。ポインタ(番地)を渡すだけで、GPUもNeural Engineも、同じメモリ番地をその場から即座にフルスピードで読み出せます。
- 狂気的なバス幅の拡張: 通常、省電力なLPDDRメモリはスマートフォン向けに使われるため、バス幅は64bit〜128bit程度です。 しかしAppleは、最上位の「Max」や「Ultra」チップにおいて、メモリの配線数(バス幅)を**「512bit」「1024bit」という、通常のPCの4倍〜8倍もの狂気的な太さに拡張しました。 これにより、HBMのような超高価な立体積層を使わずとも、「400GB/s〜800GB/s超」**という、外付けハイエンドGPUに匹敵する猛烈な帯域幅を実現したのです。
- 超巨大なメモリ容量(最大192GB)の選択肢: 外付けGPUが24GBで頭打ちになっているのを尻目に、Appleシリコンは最大64GB、128GB、192GBといった広大なユニファイドメモリをシステム全体に割り当てることができます。
算数が示す圧倒的勝利
このAppleシリコンの構造で、先ほどの40GBの70Bモデルを動かすとどうなるでしょうか? メモリ帯域幅が約800GB/sある「M2/M3/M4 Ultra」チップを搭載したMacの場合、計算はこうなります。
$$ \text{推論速度} \approx \frac{800 \text{ GB/s}}{40 \text{ GB}} \approx 20 \text{ Tokens/s} $$
1秒間に20文字から25文字。人間が目で文章を読むスピードを遥かに超える滑らかさで、700億パラメータの超知能が、ファンの音ひとつ立てずに机の上で思考を出力し続けます。 PCIeという「関所」をなくし、メモリをSoCの真横に引き寄せてバス幅を極限まで広げたという物理レイアウトの勝利が、何倍もの消費電力を喰らう巨大なデスクトップPCを完全に周回遅れにしたのです。
4. トレードオフの力学:拡張性の死と「ハンダ付けの代償」
ここまで読むと、Appleのユニファイドメモリアーキテクチャこそが完全無欠の未来に見えます。 しかし、工学の世界に「タダ飯(フリーランチ)」は存在しません。この圧倒的な帯域幅と省電力性能を手に入れるために、Appleシリコンは自作PCやエンタープライズが長年愛してきた「極めて重要な価値」を完全に生贄に捧げました。
それが、**「モジュール性(拡張性)」と「コストの透明性」**です。
後から1バイトも増やせない「使い捨て」の宿命
Appleシリコンのメモリは、SoCパッケージの上に直接ハンダ付け(BGA実装)されています。 スロット(ソケット)という物理的な接触金具を排除し、配線の長さを数センチから「ミリ単位」に切り詰めたからこそ、あの狂気的な512bitバスと低消費電力が成り立っています。
しかしそれは同時に、**「購入したあとに、メモリを1バイトたりとも増設できない」**ことを意味します。 購入時にメモリ選びを間違えれば、そのMacの性能限界は一生そのままであり、メモリが故障すれば基板ごと丸ごと破棄するしかありません。
さらに、メモリの価格設定もメーカーの完全な独占独裁になります。汎用のDRAM市場であれば数万円で買える容量差が、AppleのCTO(カスタマイズ)価格では数十万円に跳ね上がります。 「自由なパーツ交換と安価な大容量アップグレード」というx86エコシステムの美徳をすべて焼き払った焦土の上に、あの圧倒的なエッジAIの性能は咲いているのです。
結論:AI時代のコンピュータは「バス(通信路)」から逆算される
「エッジAIの戦い」の本質とは、CPUやGPUのコア数自慢ではありませんでした。 それは、「巨大なパラメータの塊を、いかに途切れさせずに演算器へとピストン輸送し続けられるか」という、配線長とバス幅の物理戦争です。
- マザーボードの広大な平野を信号が何センチも旅し、PCIeという関所で渋滞を起こす、旧来のモジュール型アーキテクチャ。
- 拡張性を潔く捨て去り、シリコンの真横に広大なメモリの湖を敷き詰めた、Appleの統合型アーキテクチャ。
クラウドの巨大データセンターが「HBMと液冷(第2話・第8話)」でメモリの壁を力任せに打ち破っているとすれば、私たちの手元にあるエッジデバイスは「ユニファイドメモリという物理配置の再定義」によって、密かに、しかし確実に革命を起こしています。
これからのパーソナルコンピュータを選ぶ基準は、もはや「CPUが何GHzか」ではありません。 「そのマシンのメモリバスは、1秒間に何百ギガバイトのデータを運べるのか?」 この物理の数字ひとつが、あなたの手元で動くAIの知能の上限を、冷酷に決定づける時代が始まっているのです。
📝 3行で頭に入る『試験・実務・投資の要点まとめ』
- 【トークン生成の数式】 LLMの推論は1文字ごとに全パラメータを読み直すため、推論速度(Tokens/s)は「メモリバス帯域幅(GB/s)÷ モデルサイズ(GB)」の割り算で物理的に100%決定される。
- 【Windows機の限界】 GPUのVRAM(最大24GB)から溢れたデータがPCIeバス(約32GB/s)や低速なDDR5を通ることで大渋滞が発生し、推論速度が1トークン/秒以下に急落する。
- 【ユニファイドメモリの覇権】 AppleシリコンはCPU/GPU共有のメモリをSoCの真横に直結し、512bit超の狂気的なバス幅で最大800GB/s超の帯域幅を確保。拡張性を生贄にエッジAIの絶対王座に就いた。