KVキャッシュと推論のメモリ壁――なぜChatGPTは1文字ずつしか出せないのか? GPUが99%遊んでいるのに待たされる物理のからくり
1. 素朴な疑問:なぜ読むときは一瞬なのに、書くときは1文字ずつなのか?
ChatGPTやClaudeを使っていて、誰もが目にする日常的な光景があります。
あなたが百科事典の1ページ分に匹敵する、数千文字もの長大な文章をプロンプトとして貼り付けて送信したとします。 画面の向こうのAIは、その長大な文章をわずか0.1秒〜0.2秒の瞬きする間に読み終えます。
ところが、AIが返事を書き始めると、様子が一変します。 まるでタイピストがキーボードを叩いているかのように、「1文字……また1文字……」とカタカタカタと一定の速度でポツポツ出力されていきます。
なぜ、読むときは数千文字を瞬時に並列処理できるのに、書くときは1文字ずつしか出力できないのでしょうか? なぜ「答えの文章全体」を一瞬でまとめて画面に出してくれないのでしょうか?
さらに不可解な現象があります。
サーバー側のGPUモニター(nvidia-smi)を監視してみると、この1文字を出力している最中、GPUの計算コア(テンソルコア)の稼働率はわずか数%〜十数%で、残りの90%近くは腕を組んで遊んでいるのです。
計算機が暇を持て余しているのに、なぜ推論速度は上がらないのか? そして、なぜ長い会話を続けるとGPUのVRAM(ビデオメモリ)が突如としてパンク(OOM)してしまうのか?
その裏には、生成AIの宿命である**「自己回帰(Auto-regressive)の足かせ」と、半導体物理の最前線である「メモリバンド幅の壁(Memory Wall)」**が横たわっています。
2. Prefill(並列)とDecode(逐次):LLM推論の「二面性」
LLMの推論処理は、実は全く性質の異なる2つのフェーズに明確に分かれています。
- プリフィル(Prefill)フェーズ: ユーザーから送られた入力プロンプト全体を一度に読み込む段階
- デコード(Decode)フェーズ: 次のトークンを1つずつ順番に生成し続ける段階
なぜ文章全体を一括で出力できないのか?
第1話で学んだ通り、現代のLLMは**自己回帰モデル(Auto-regressive Model)**です。 数式で言えば、次の確率を計算しています。
$$P(w_{t+1} \mid w_1, w_2, \dots, w_t)$$
「5番目の単語」が何になるかは、「4番目の単語」が決まるまで宇宙の誰も知り得ません。 「4番目の単語」が決まって初めて、それを文脈に付け足して「5番目の単語」の確率計算が走ります。
未来の単語が過去の単語に依存している以上、「前の文字を出し、それを入力に加えて次の文字を出す」という一本道のステップ(逐次処理)を物理的にスキップすることは絶対にできないのです。
3. 破滅の再計算ループ:KVキャッシュがない世界の絶望
では、この逐次生成を素朴に実装するとどうなるでしょうか?
ステップ1: "The"                 → "cat" を生成
ステップ2: "The cat"             → "sat" を生成
ステップ3: "The cat sat"         → "on" を生成
ステップ4: "The cat sat on" → "the" を生成ここに、恐るべき計算の無駄が潜んでいます。
ステップ4で「the」を予測しようとするとき、私たちはモデルに「The cat sat on」の4単語を入力します。 するとモデルは、4単語すべての $Q, K, V$ ベクトルを最初から計算し直し、Attentionの内積を取り直します。
しかし、よく考えてみてください。 過去の単語「The」や「cat」の $K$(Key)と $V$(Value)ベクトルは、何千回再計算したところで、昨日も今日も明日も全く同じ数値です。重み行列 $W_K, W_V$ が変わらない以上、同じ単語から生まれる $K$ と $V$ が変わるはずがありません。
もし過去の計算を毎回最初からやり直していたら、1000文字の文章を出力するのに要する計算量は $1 + 2 + 3 + \dots + 1000 \approx \frac{1000^2}{2} =$ 50万ステップへと二次関数的に爆発($O(N^2)$)します。文字を打てば打つほど、AIの出力速度はカタツムリのように遅くなり、使い物にならなくなります。
救世主「KVキャッシュ」の降臨
この無駄を根絶するために開発されたのが、**「KVキャッシュ(KV Cache)」**です。
発想は至極当然です。 「一度計算した過去の全トークンの $K$(Key)と $V$(Value)ベクトルを、GPUのビデオメモリ(VRAM)の中に大切に保存(キャッシュ)しておけ!」
次の単語を生成するときは:
- 新しく生まれた「直前の1トークン」だけを入力する。
- その1トークンの $Q_{\text{new}}, K_{\text{new}}, V_{\text{new}}$ だけを計算する(入力長は常に $1$!)。
- メモリに保存してあった「過去全員の $K_{\text{past}}$ と $V_{\text{past}}$」を取り出し、末尾に新しい $K_{\text{new}}, V_{\text{new}}$ をガッチャンコと追記する。
- $Q_{\text{new}}$(1単語分)と、合体した $K_{\text{all}}$(過去全員分)の間で内積を計算する。
このキャッシュ機構のおかげで、毎ステップの計算量は「常に新しい1トークン分($O(1)$)」で済み、全体の計算量は $O(N)$ へと劇的に圧縮されました。
しかし――この救世主こそが、GPUメモリを食い尽くす恐るべき怪物の正体だったのです。
触って試す:KVキャッシュの効果体験
🧮 KVキャッシュの効果体験(1トークンずつ生成)
「次のトークンを生成」ボタンを押すたびに、文章が1トークン伸びます。キャッシュなしは毎回「過去の全トークン分」を再計算するので累積ステップ数が二乗で膨らみ、キャッシュありは「新しい1トークン分」だけなので線形のままです。
❌ キャッシュなし(毎回全文を再計算)
今回の計算:0 ステップ / 累積:0 ステップ
✅ KVキャッシュあり(新しい1トークンだけ計算)
今回の計算:0 ステップ / 累積:0 ステップ
ボタンを押して、トークンを生成してみてください。
生成済みトークン:0
4. 算術の戦慄:KVキャッシュが消費するVRAMの計算式
「たかが過去のKeyとValueをメモリに置くだけなら、大した容量ではないのでは?」
そう油断したエンジニアを絶望に叩き落とすのが、KVキャッシュのメモリ計算式です。 LLMのアーキテクチャパラメータから、KVキャッシュが消費するバイト数を厳密に計算してみましょう。
【1トークンあたりのKVキャッシュ消費バイト数】
Size = 2 (KとVの2つ)
     × 2 (FP16なら1要素2バイト)
     × レイヤー数 (Layers)
     × ヘッド数 (Heads)
     × ヘッド次元 (d_k)
ここで、$Heads \times d_k$ はモデルの隠れ層次元 $D$(Hidden Dim)に等しいため、式は以下のように書き直せます。
$$\text{1トークンあたりの容量} = 4 \times \text{Layers} \times D \quad (\text{バイト})$$
巨大モデル(Llama 2 70B)で計算してみる
かつて世界標準だった巨大モデル「Llama 2(70B)」のスペックを代入してみましょう。
- レイヤー数(Layers):80 層
- 隠れ層次元($D$):8,192 次元
$$\text{1トークンあたり} = 4 \times 80 \times 8,192 = 2,621,440 \text{ バイト} \approx \mathbf{2.62 \text{ MB / トークン}}$$
たった1文字(1トークン)文脈が進むだけで、メモリが「2.6 MB」ずつ確実に削り取られていきます。
コンテキスト長が8,000トークンに達しただけで、たった1人のユーザーの会話のKVキャッシュを保持するためだけに「21 GB」ものVRAMが消滅します。 もしWebサービスとして同時に32人のユーザーが会話していたら、それだけで 670 GB以上 のメモリがKVキャッシュだけで埋め尽くされます。
モデルの重み(Weights)を展開するだけでも140GB必要なのに、その上にテラバイト級のKVキャッシュがのしかかってくる。 生成AIのクラウドインフラが悲鳴を上げている最大の真因は、このKVキャッシュの幾何級数的なメモリ膨張にあるのです。
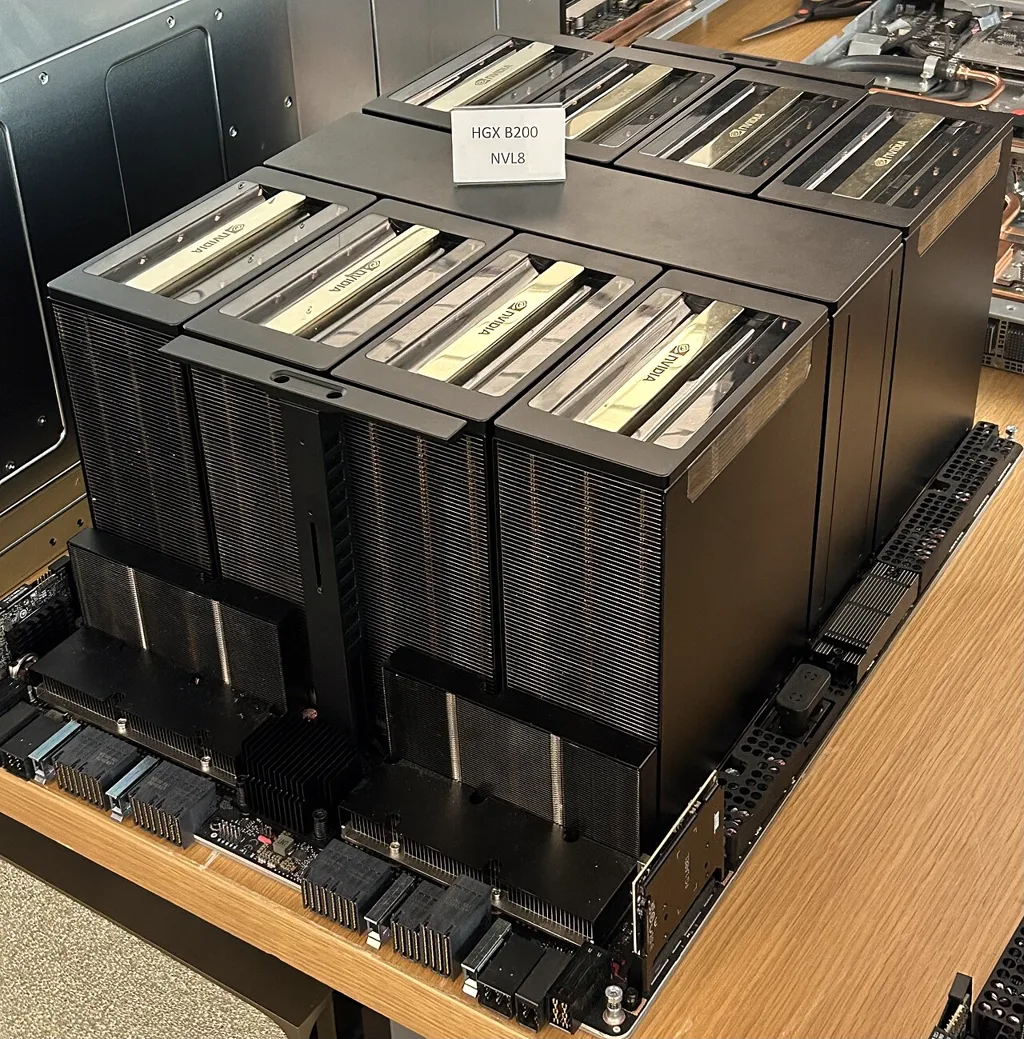

5. 物理の壁:なぜGPUが遊んでいるのに遅いのか?(B/F比とルーフライン)
冒頭の謎に戻りましょう。 「なぜデコード中、GPUの計算コアは数%しか稼働していないのに、推論速度は上がらないのか?」
この謎を解く鍵が、コンピュータアーキテクチャの絶対の法則、**「ルーフライン・モデル(Roofline Model)」と「演算強度(Operational Intensity / B/F比)」**です。
コンピュータの処理性能には、2つの限界(天井)しか存在しません。
- コンピュート・バウンド(計算律速): メモリ転送は十分間に合っており、CPU/GPUの「計算速度(FLOPS)」がボトルネックになっている状態。
- メモリ・バウンド(メモリ帯域律速): 計算コアは超高速だが、メモリからデータが届くのが遅すぎて、コアが「データ待ち(飢餓)」で立ち尽くしている状態。
1回の計算のために、140GBの辞書を丸ごと読み直す
デコードフェーズの物理を、数字で見てみましょう。 70B(700億パラメータ)のモデルは、16bit浮動小数点(FP16)で約140 GBの重みデータを持っています。
新しい1トークンを生成するとき、入力ベクトルは「たったの1単語(長さ1)」です。 モデルはこの1単語に重み行列を掛け算するために、GPUのHBM(高帯域メモリ)から、140GBの重みパラメータ全体を、GPUの演算コアへ向けて丸ごと一瞬でロードしなければなりません。
【デコード1回の悲惨な収支】
メモリから読み出すデータ量 : 140 GB(モデルの重み)+ 数GB(KVキャッシュ)
実行する計算量             : わずか数億回(1単語分の掛け算)
最新のモンスターGPU「NVIDIA H100」のHBM3メモリ帯域は、人類史上最速の**「毎秒3.35 TB(3,350 GB/s)」**を誇ります。 では、このH100を使って、140GBの重みを1回読み出すのに何秒かかるでしょうか?
$$\text{所要時間} = \frac{140 \text{ GB}}{3,350 \text{ GB/s}} \approx \mathbf{0.0418 \text{ 秒(約 42 ミリ秒)}}$$
1秒間に処理できる回数は:
$$\text{最大生成速度} = \frac{1 \text{ 秒}}{0.0418 \text{ 秒}} \approx \mathbf{24 \text{ トークン / 秒}}$$
出ました。「秒間24文字」。 これが、私たちが画面で見ているChatGPTのタイピング速度の正体です。
GPUの演算コアが遅いのではありません。 「140GBもの巨漢データを、HBMメモリからシリコンの配線(銅線)を通してコアへ転送する速度」が毎秒3.35TBで頭打ちになっているからです。
計算コアは「計算する相手(重みデータ)」がメモリから届くのを首を長くして待っており、データが届いた瞬間に0.0001秒で計算を終わらせ、また次の140GBが届くまで腕を組んで待機する。 デコードフェーズとは、純度100%の**「メモリバンド幅の物理戦争」**だったのです。
6. PagedAttentionの革命:メモリ断片化をOSの「仮想記憶」で粉砕する
KVキャッシュの肥大化とメモリ帯域の壁。 この2重苦に喘いでいたオープンソースAI界に、2023年、スタンフォード大学やUCバークレー校の研究者チーム(Woosuk Kwonら)が決定的なブレイクスルーをもたらしました。
それが、現在あらゆる商用推論エンジン(vLLM)の標準基盤となった**「PagedAttention」**です。
従来の巨大な無駄:メモリの60%以上が使われずに捨てられていた
PagedAttentionが登場する前、エンジニアたちは絶望的なメモリ浪費に苦しんでいました。
PyTorchのテンソルは、メモリ上で**「一続きの連続した領域(Contiguous Memory)」**に配置されなければならないという大原則があります。 そのため、ユーザーが接続してきた瞬間、システムは「このユーザーは最大で2048トークン話すかもしれない」と想定し、まだ何も話していないうちから2048トークン分の巨大な連続VRAMをドカンと予約確保していました。
しかし、実際のユーザーの8割は「こんにちは」とか「Pythonでフィボナッチ数を書いて」といった、数十〜数百トークンの短い会話で終わります。 予約された残りの広大なVRAMは、誰にも使われないまま虚無の空間として占有され、物理VRAMの60%〜80%が「ただの予約枠」としてドブに捨てられていたのです。
OSの「ページテーブル」をGPUに再現する
PagedAttentionの発想は、コンピュータサイエンスの原点回帰でした。 「1960年代にOSがメモリ不足を解決した『仮想記憶(Virtual Memory)とページング方式』を、GPUのKVキャッシュにそのまま移植しよう!」
- ブロック分割: KVキャッシュを連続領域として確保するのをやめ、「16トークン分」などの小さな**ブロック(ページ)**に細切れにする。
- 物理配置の自由化: 物理メモリ上のどこにブロックがあっても構わない。バラバラの飛び地にある空き領域に配置する。
- ブロックテーブル(ページテーブル): 「トークン0〜15は物理ブロック7」「トークン16〜31は物理ブロック2」という対応表(マップ)を管理する。
Attentionの計算を行うとき、GPUカーネルはブロックテーブルを参照しながら、飛び地に散らばったKeyとValueをオンザフライで読み込んで内積を計算します。
この発明により、メモリの無駄(断片化)はほぼゼロになり、同じGPUサーバーが同時にさばけるユーザー数(スループット)は一撃で2倍〜4倍に跳ね上がりました。 低レイヤのOSの知恵が、半世紀の時を超えて最先端AIの救世主となった瞬間です。
7. 完全実装:NumPyで作る「KVキャッシュ付きデコード」
それでは、ここまでの理論をコードで完全に体感してみましょう。 外部フレームワークを一切使わず、**「KVキャッシュなしの素朴な再計算」と「KVキャッシュを使った差分更新」**の動作をNumPyだけで実装し、両者が全く同じアテンション結果を出力しながら、計算手順がどう異なるかを検証します。
ファイル名を min_kv_cache.py として保存してください。
import numpy as np

def softmax(x: np.ndarray, axis=-1) -> np.ndarray:
    e_x = np.exp(x - np.max(x, axis=axis, keepdims=True))
    return e_x / np.sum(e_x, axis=axis, keepdims=True)


class MinimalKVCacheAttention:
    """単一ヘッド・因果マスク対応の最小KVキャッシュ検証クラス"""
    def __init__(self, hidden_dim: int):
        self.hidden_dim = hidden_dim
        np.random.seed(42)
        # 射影重み
        self.W_q = np.random.randn(hidden_dim, hidden_dim) * 0.1
        self.W_k = np.random.randn(hidden_dim, hidden_dim) * 0.1
        self.W_v = np.random.randn(hidden_dim, hidden_dim) * 0.1

        # KVキャッシュの初期化 (最初は空)
        self.k_cache = None
        self.v_cache = None

    def reset_cache(self):
        self.k_cache = None
        self.v_cache = None

    def forward_without_cache(self, all_tokens_x: np.ndarray) -> np.ndarray:
        """
        【キャッシュなし】過去の全トークンを入力して最初から全部計算し直す (無駄の極致)
        all_tokens_x: [1, Current_Seq_Len, Hidden_Dim]
        戻り値: 最新トークンの出力ベクトル [1, 1, Hidden_Dim]
        """
        B, S, D = all_tokens_x.shape
        # 全トークンの Q, K, V を毎回再計算
        Q = all_tokens_x @ self.W_q
        K = all_tokens_x @ self.W_k
        V = all_tokens_x @ self.W_v

        # 最後のトークンの Query だけを取り出す
        q_last = Q[:, -1:, :]  # [1, 1, D]

        # 内積: [1, 1, D] @ [1, D, S] -> [1, 1, S]
        scores = (q_last @ K.transpose(0, 2, 1)) / np.sqrt(D)
        weights = softmax(scores, axis=-1)

        # 出力: [1, 1, S] @ [1, S, D] -> [1, 1, D]
        output = weights @ V
        return output

    def forward_with_cache(self, new_token_x: np.ndarray) -> np.ndarray:
        """
        【KVキャッシュあり】新しく生成された『直前の1トークンだけ』を入力する (爆速)
        new_token_x: [1, 1, Hidden_Dim] (常に系列長は 1!)
        戻り値: 最新トークンの出力ベクトル [1, 1, Hidden_Dim]
        """
        B, S, D = new_token_x.shape
        assert S == 1, "デコードフェーズの入力系列長は常に 1 である必要があります"

        # 1. 新しい1トークンだけの Q, K, V を計算 (計算量は極小!)
        q_new = new_token_x @ self.W_q  # [1, 1, D]
        k_new = new_token_x @ self.W_k  # [1, 1, D]
        v_new = new_token_x @ self.W_v  # [1, 1, D]

        # 2. KVキャッシュの更新(過去のキャッシュの末尾に新しいK, Vを連結)
        if self.k_cache is None:
            self.k_cache = k_new
            self.v_cache = v_new
        else:
            # 軸 1 (Seq_Len方向) にガッチャンコと追記
            self.k_cache = np.concatenate([self.k_cache, k_new], axis=1)
            self.v_cache = np.concatenate([self.v_cache, v_new], axis=1)

        # 3. 新しいQ(1単語)と、過去全員のK(全単語)で内積を計算!
        # [1, 1, D] @ [1, D, Total_Seq_Len] -> [1, 1, Total_Seq_Len]
        scores = (q_new @ self.k_cache.transpose(0, 2, 1)) / np.sqrt(D)
        weights = softmax(scores, axis=-1)

        # 4. 過去全員のVの加重平均
        # [1, 1, Total_Seq_Len] @ [1, Total_Seq_Len, D] -> [1, 1, D]
        output = weights @ self.v_cache
        return output


# -------------------------------------------------------------
# 実験:逐次デコードのシミュレーションと完全一致の検証
# -------------------------------------------------------------
if __name__ == "__main__":
    D = 4  # 隠れ層次元
    # 仮想の生成プロセス: 4ステップかけて4つのトークンを順次生成する
    np.random.seed(100)
    tokens_stream = [np.random.randn(1, 1, D) for _ in range(4)]

    attn = MinimalKVCacheAttention(hidden_dim=D)

    print("=== デコードプロセスのシミュレーション (全4ステップ) ===\n")

    for step in range(len(tokens_stream)):
        current_new_token = tokens_stream[step]
        # これまでに生成された全トークン列の結合
        all_tokens_so_far = np.concatenate(tokens_stream[:step + 1], axis=1)

        # 方式A: キャッシュなし(全トークンを再入力)
        out_no_cache = attn.forward_without_cache(all_tokens_so_far)

        # 方式B: キャッシュあり(新トークン1個だけ入力)
        out_with_cache = attn.forward_with_cache(current_new_token)

        # 2つの出力が一致しているか検証
        diff = np.max(np.abs(out_no_cache - out_with_cache))
        cache_len = attn.k_cache.shape[1]

        print(f"【Step {step + 1}】")
        print(f"  入力系列長         : キャッシュなし = {all_tokens_so_far.shape[1]}, キャッシュあり = {current_new_token.shape[1]}")
        print(f"  現在のKVキャッシュ長: {cache_len} トークン分保持中 (Shape: {attn.k_cache.shape})")
        print(f"  両者の出力ベクトルの最大誤差: {diff:.1e}")
        print("  -> " + ("完全一致! 数学的に寸分の狂いもありません。" if diff < 1e-10 else "不一致エラー"))
        print()
実行結果
=== デコードプロセスのシミュレーション (全4ステップ) ===

【Step 1】
  入力系列長         : キャッシュなし = 1, キャッシュあり = 1
  現在のKVキャッシュ長: 1 トークン分保持中 (Shape: (1, 1, 4))
  両者の出力ベクトルの最大誤差: 0.0e+00
  -> 完全一致! 数学的に寸分の狂いもありません。

【Step 2】
  入力系列長         : キャッシュなし = 2, キャッシュあり = 1
  現在のKVキャッシュ長: 2 トークン分保持中 (Shape: (1, 2, 4))
  両者の出力ベクトルの最大誤差: 0.0e+00
  -> 完全一致! 数学的に寸分の狂いもありません。

【Step 3】
  入力系列長         : キャッシュなし = 3, キャッシュあり = 1
  現在のKVキャッシュ長: 3 トークン分保持中 (Shape: (1, 3, 4))
  両者の出力ベクトルの最大誤差: 0.0e+00
  -> 完全一致! 数学的に寸分の狂いもありません。

【Step 4】
  入力系列長         : キャッシュなし = 4, キャッシュあり = 1
  現在のKVキャッシュ長: 4 トークン分保持中 (Shape: (1, 4, 4))
  両者の出力ベクトルの最大誤差: 0.0e+00
  -> 完全一致! 数学的に寸分の狂いもありません。
コードが示す決定的真実
Step 4 の入力系列長を見てください。
- キャッシュなし方式は、ステップが進むごとに
1 -> 2 -> 3 -> 4と入力が長くなり、計算負荷が増大していきます。 - 一方、キャッシュあり方式は、**何ステップ進もうが入力系列長は常に「
1」**のままです。
そして、出力されたベクトルは誤差 0.0e+00 で完全一致しています。
過去の計算結果をメモリに人質として預けておくことで、私たちは「再計算の地獄」から完全に解放されたのです。
8. テンソルの視点:デコード時におけるShapeの特異性
ここで、デコードフェーズにおけるテンソル形状(Shape)の決定的な違いを整理します。 ここを理解していないと、推論エンジンのソースコードを読んだときに必ず混乱します。
【プリフィル時(入力プロンプト処理)】
入力 X   : [Batch, Seq_Len=1000, Hidden_Dim]  ← 1000単語を一括処理!
Q, K, V  : [Batch, 1000, Hidden_Dim]
Scores   : [Batch, 1000, 1000]                ← 正方行列の巨大な内積!

【デコード時(KVキャッシュ使用・1トークン生成)】
入力 X   : [Batch, Seq_Len=1, Hidden_Dim]     ← ★系列長は常に「1」!
Q        : [Batch, 1, Hidden_Dim]             ← 新しい1単語だけ!
K_cache  : [Batch, Past_Len + 1, Hidden_Dim]  ← 過去全員の蓄積!
V_cache  : [Batch, Past_Len + 1, Hidden_Dim]  ← 過去全員の蓄積!
Scores   : [Batch, 1, Past_Len + 1]           ← ★正方行列ではなく「細長い長方形」!
Output   : [Batch, 1, Hidden_Dim]             ← 次の1単語の特徴量が出現!
デコード時のアテンションスコア行列は、もはや正方行列 [S, S] ではありません。
**[1, Past_Len + 1] という極めて横長な「1行のベクトル」**になります。
新しい1単語(Query)が、過去の全歴史(Key)という長い巻物をサッと見渡し、過去の全情報(Value)をブレンドして、次の1文字を決定する。 これが、毎秒数十回繰り返されているデコードループの正体です。
9. まとめ:推論エンジニアリングの主戦場は「計算」から「メモリ」へ
KVキャッシュと推論の物理を総括すると、以下のようになります。
- 二面性の真実: 入力読み込み(Prefill)はGPUコアをフル稼働させる計算律速だが、出力生成(Decode)は1トークンずつ進む自己回帰のメモリ帯域律速である。
- KVキャッシュの代償: 再計算を排除して計算量を $O(N)$ に圧縮する代償として、長文コンテキストでは数十GB単位のVRAMを食い潰す巨大な怪物となる。
- タイピング速度の物理限界: 1文字出力するたびに数百GBのモデル重みをHBMメモリから全量ロードしなければならないため、推論速度はHBMの転送速度(TB/s)によって物理的に上限が縛られている。
- PagedAttentionの英断: メモリの連続領域確保を捨て、OSの仮想記憶と同じページング方式を導入することで、断片化を根絶しサービング効率を劇的に跳ね上げた。
モデルは文脈を理解し、知識を引き出し、KVキャッシュによって過去を記憶しながら、次の1単語の「確率の候補(Logits)」を導き出しました。
しかし、最後の最後に、もう1つだけ重大な謎が残っています。
「モデルが計算した最後の数字は、ただの『確率のパーセンテージ』に過ぎない。そこからどうやって、AIは実際の『言葉』を選び取っているのか?」 「設定画面にある『Temperature(温度)』『Top-p』『Top-k』というツマミを回すと、なぜAIは急に詩人のように饒舌になったり、機械のように几帳面になったりするのか?」
確率の海から知的な言葉を釣り上げるサンプリングの物理工学。 次回、**「第10話:サンプリングの物理工学――Temperature, Top-p, Top-kとは何の確率操作か?」**へと進みましょう。
📝 3行で頭に入る『試験・実務の要点まとめ』
- PrefillとDecodeの二面性: 入力処理(Prefill)は巨大な行列積でGPUコアを使い切るCompute-boundだが、逐次生成(Decode)は1トークンごとにモデル重み全量をメモリから読むMemory-bound(帯域律速)である。
- KVキャッシュのトレードオフ: 過去トークンの $K, V$ をVRAMに保持して再計算($O(N^2)$)を防ぐが、長文や高並列環境では数十〜数百GBのメモリを占有しVRAM枯渇(OOM)の主因となる。
- PagedAttentionの革命: 従来の連続メモリ確保による内部断片化(メモリの6割以上の浪費)を、OSの仮想記憶にならったブロック単位のページング管理で排除し、推論スループットを数倍に引き上げた。