次世代コンピューティングの到達点(データセンターという1つの巨大なチップ)
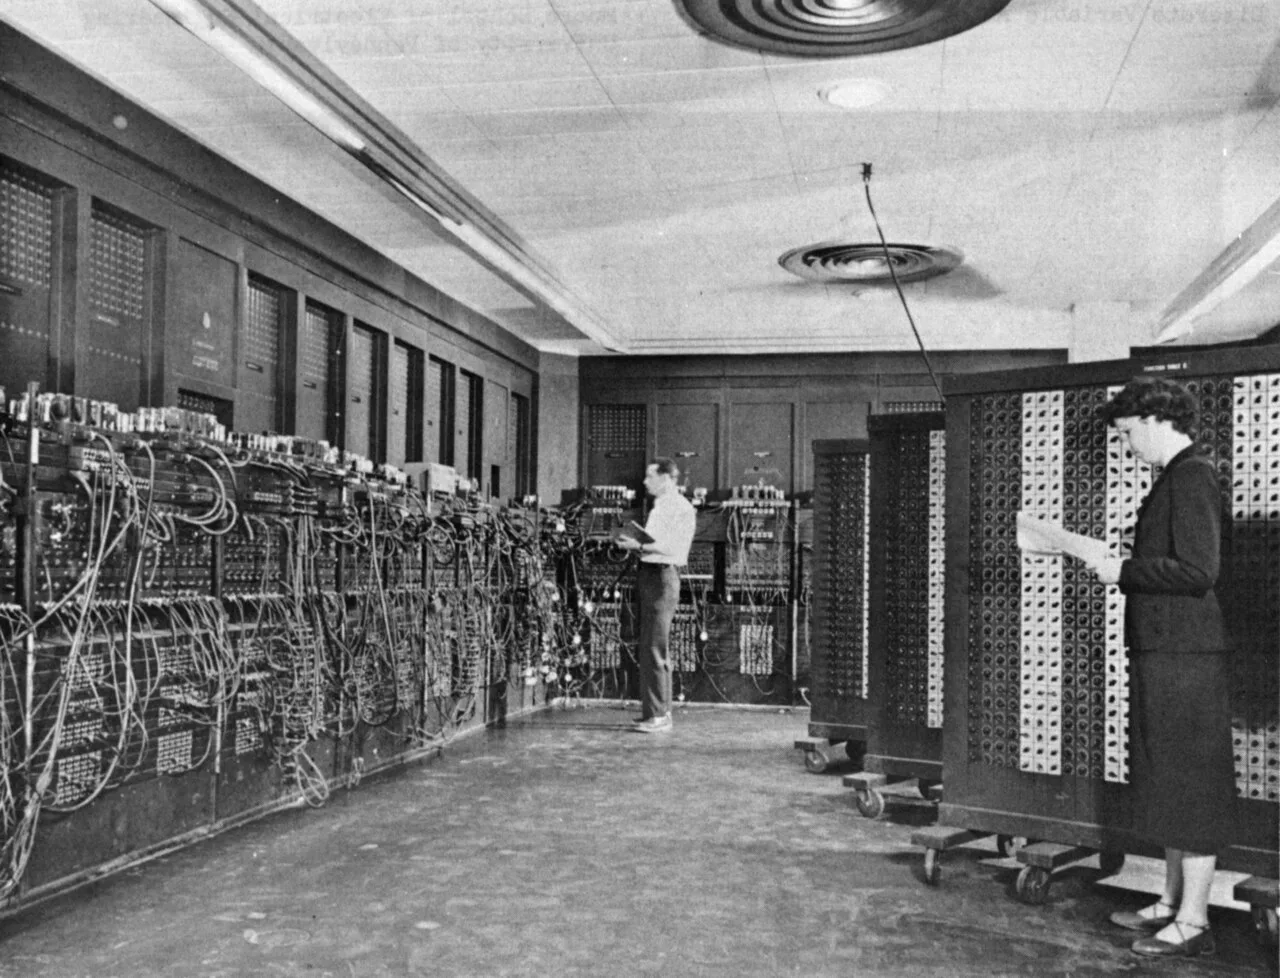
1945年、数学者ジョン・フォン・ノイマンが提唱した「プログラム内蔵型コンピュータ(ノイマン型アーキテクチャ)」の誕生から約80年。 私たちは長きにわたり、ある「当たり前の前提」に縛られてきました。
「CPUという計算機があり、離れた場所にメモリという本棚があり、両者をバスという道で繋ぎ、命令を1つずつ取り出して実行する」
しかし、本連載で解剖してきた通り、この美しい前提は、AIが要求するデータの津波の前に完全に瓦解しました。
- 演算器の速度にデータ供給が追いつかない「メモリの壁(第2話)」
- 信号が減衰し、熱となって燃え尽きる「銅線の死(第7話)」
- 1枚の大きなチップを作れなくなった「モノリシックの限界(第6話)」
- そして、都市丸ごとの電力を貪りサウナのように煮えたぎる「熱と電力の壁(第8話)」
人類は今、これらすべての物理的ボトルネックを力尽くで破壊し続けています。 では、あらゆる摩擦と遅延を極限まで削ぎ落とした先にある「未来のコンピュータ」とは、一体どのような姿をしているのでしょうか?
「チップ」という小さな箱庭を飛び出し、データセンター、ひいては地球規模のインフラそのものが1つの知能へと変貌する、次世代コンピューティングの終着点を解き明かします。

1. ノイマンの呪縛を解く:移動させずに解く「インメモリ計算」
コンピュータが消費するエネルギーの大部分は、実は「計算(ロジックの反転)」そのものではなく、**「メモリとプロセッサの間をデータを往復させる配線の抵抗熱」**によって浪費されています。
「計算する場所と、記憶する場所が分かれているから遅く、熱が出る」 ならば、80年続いたノイマン型アーキテクチャを捨て去る究極の解決策はただ1つです。
「データを一切移動させず、データが眠っているメモリセルそのものの中で計算させればいい」
これが、次世代アーキテクチャの急先鋒である**「インメモリ計算(In-Memory Computing / Processing-in-Memory:PIM)」**です。
オームの法則とキルヒホッフの法則で「行列積」が一瞬で解ける
AIの根幹である「行列の掛け算と足し算(積和演算:GEMM)」は、インメモリ計算を用いると、驚くべきことに**「中学校で習う電気回路の物理法則」**だけで一瞬で完了します。
メモリ素子(ReRAMや相変化メモリPCMなど)を碁盤の目(クロスバーアレイ)状に並べ、各素子の「電気抵抗(コンダクタンス $G$)」にAIの重みパラメータを書き込んでおきます。 そこに、入力データに応じた「電圧 $V$」を一斉に印加します。
- 掛け算(オームの法則): 各メモリ素子を通り抜ける電流 $I$ は、$I = V \times G$ となり、電圧と抵抗値の「掛け算」が物理的に自動成立します。
- 足し算(キルヒホッフの電流則): 縦の配線に集まった電流は自然に合流し、合計電流 $\sum I$ となります。何もしなくても物理現象として「足し算」が完了します。
デジタル回路のように何千万回もクロックを刻み、0と1をパチパチ切り替える必要はありません。 「電圧をかけた瞬間に、物理法則そのものが計算結果として電流を吐き出す」。 データの移動距離はゼロ、計算時間はほぼ一瞬($O(1)$)、消費電力は従来の10分の1から100分の1へと激減します。これが、メモリの壁を根底から無効化する第1の到達点です。
2. 電子から光子への完全脱皮:「光回路ニューロモーフィック」
インメモリ計算が「メモリの中」の革命だとすれば、チップ間の計算そのものを光で行うのが**「光コンピューティング(光ニューロモーフィック・コンピューティング)」**です。
第7話で解説した通り、電気(電子)は導体の中を進むときに抵抗を受け、周波数を上げると表皮効果で熱を出します。 しかし、「光子(フォトン)」には電荷がありません。光子同士は衝突せず、摩擦熱も発生せず、真空中であれば秒速30万キロメートルという宇宙の最高速度で進みます。
波の「干渉」が行列計算を瞬時に終わらせる
シリコン基板上に形成された光導波路に、**「マッハ・ツェンダー干渉計(MZI)」**と呼ばれる超小型の光スイッチを組み込みます。 光を2つの経路に分け、片方の経路の屈折率をわずかに変化させてから再び合流させると、光の波がお互いを強め合ったり(建設的干渉)、打ち消し合ったり(相殺的干渉)します。
この「光の波が重なり合って明るさが変わる」という光学現象は、数学的には**「ユニタリ行列の掛け算」と完全に等価です。 レーザー光を光回路の入り口からピピッとお祈りするように流し込むだけで、光が回路を通り抜けるわずか数ピコ秒(1兆分の1秒)の間に、数百億回分の行列演算が完了し、出口から計算結果の光が飛び出してくる**のです。
抵抗熱による発熱限界(熱の壁)に縛られた電子回路を尻目に、光コンピューティングは「エネルギー消費ほぼゼロの超高速演算」という、究極の物理限界へと手を伸ばしています。
3. チップの限界を空間で破る:「ウエハスケール・エンジン」
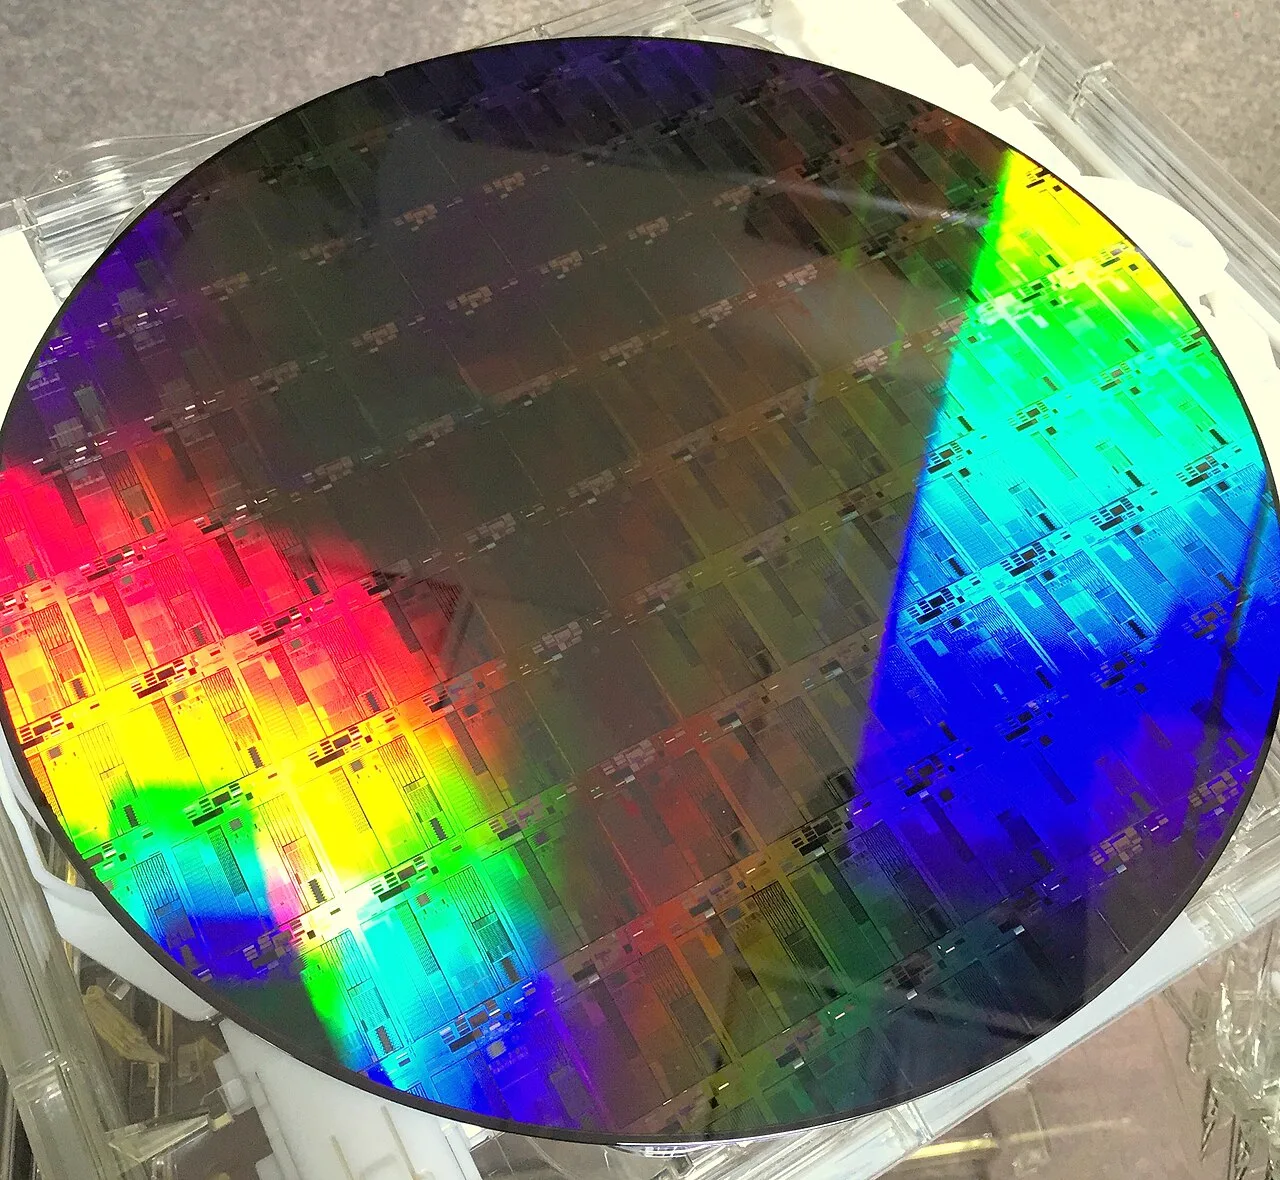
「微細化が限界なら、チップを小さく切り刻むのをやめればいい」 この狂気の逆転思想を現実のものにしたのが、米Cerebras Systems(セレブラス)の**「ウエハスケール・エンジン(WSE)」**です。
通常、直径300ミリメートルのシリコンウエハからは、数百個のGPUやCPUチップが四角く切り出されます(第6話)。 しかしCerebrasは、**「ウエハを一切切り刻まず、300mmの円盤丸ごと1枚を、1個の巨大な四角いチップとして使う」**という前代未聞の怪物を創り出しました。

境界線のないシリコンの大陸
レチクル限界(露光装置の枠)を越えるため、CerebrasはTSMCと共同で、露光の枠と枠の間の境界線に配線を架橋する特殊技術を開発しました。 その結果生まれたチップは、面積が通常の巨大GPUの50倍以上(約46,225平方ミリメートル)。数十万〜数百万個のAIコアと、数十ギガバイトもの超高速SRAMが、1枚のシリコンウエハの上に切れ目なく敷き詰められています。
すべてのコアがシリコン上の極微配線で直結されているため、チップ間通信の遅延は外部ケーブルの数千分の1(ナノ秒未満)、内部帯域幅は**毎秒数十ペタバイト(PB/s)**に達します。 「パッケージング」「マザーボード」「LANケーブル」という中継地点をすべて焼き払い、シリコンの物理的広がりそのもので力尽くの計算を行う。これもまた、ボトルネックを破壊したひとつの到達点です。
4. データセンター・アズ・ア・コンピュータ(ラックという1つの頭脳)
しかし、ウエハスケールですら、急速に肥大化する人類のフロンティアモデル(数兆〜数十兆パラメータのAI)を1枚で呑み込むことはできません。 必然的に、コンピューティングの最終進化形は、本連載で追ってきたすべての技術が結実する場所――**「データセンタースケール・コンピューティング」**へと収斂します。
もはや、最新のデータセンターにおいて「1台のPC」「1台のサーバー」という概念は完全に意味を失いました。

サーバーケースという「壁」の融解
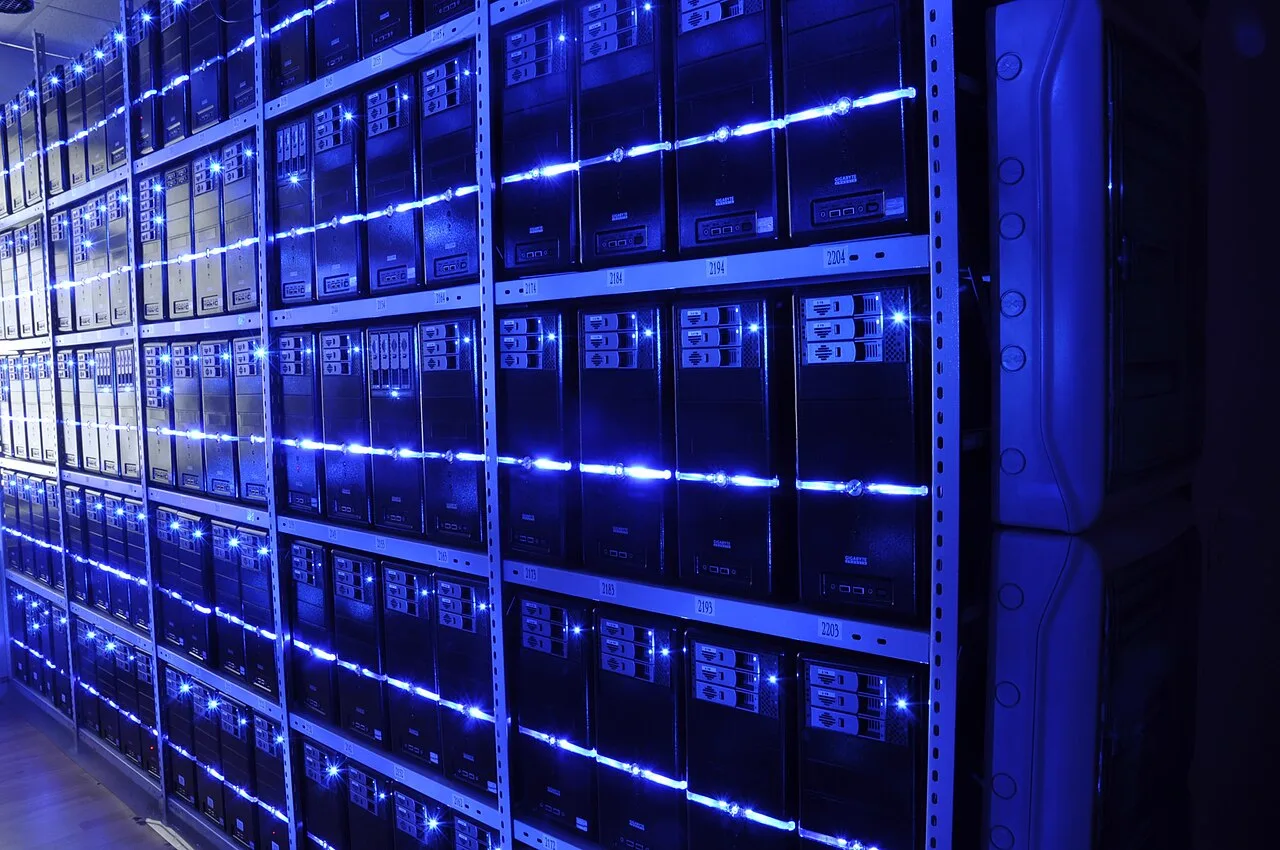
従来のデータセンターは、「サーバー」と呼ばれる金属の箱が棚(ラック)に並び、それらがLANケーブルで繋がれている「集合住宅」でした。 しかし、現代のAIデータセンター(NVIDIA GB200 NVL72や次世代メガクラスタ)は違います。
- 筐体の消滅:個々のサーバーを密閉する箱はなく、ラック全体が1つの巨大なフレームとして設計される。
- バスの巨大化:ラックの背骨には、銅の極太バスバー(48V直流給電)と、毎秒数百テラバイトの通信を担うNVLinkバックプレーンが貫通している。
- 血液としての水:超純水が毎分数百リットルの勢いでラック中を駆け巡り、120kWの熱エネルギーを瞬時に吸い上げて屋外へ押し流す(直接液冷)。
- 光による神経網:ラックとラック、棟と棟の間は、CPO(光電融合)によってシリコンから直接引き出された数万本の光ファイバーが、光速でデータをテレポートさせる。
ここにあるのは、「数万台の独立したコンピュータの集まり」ではありません。 全体として完全に同期し、単一のメモリ空間(共有プール)を共有し、ナノ秒単位の遅延で協調動作する**「データセンターという名の、敷地面積数千平米に及ぶ1つの巨大なチップ」**です。
触って試す:スケールの指数体験
📈 スケールの指数体験(計算需要が毎年2倍に増え続けたら?)
起点は記事の数字です。GPU「数万枚」、電力「ギガワット級」、ラックの発熱「120kW」。ここからAIの計算需要が毎年2倍に増え続けたと仮定すると、規模はどう膨らむでしょうか。年数を選んでみてください。
年数のボタンを押してみてください。
5. フィジカルAIの母体へ:惑星規模の神経系
なぜ、人類はここまで狂気的な設備投資を行い、変圧器を取り合い、ナノの界面化学を極め、地球の電力を注ぎ込んで「巨大な1つのコンピュータ」を作り上げようとしているのでしょうか?
その理由は、AIの主戦場が「画面の中のテキスト生成(チャットボット)」から、**「現実の物理空間をリアルタイムに認識し、制御するフィジカルAI(Physical AI)」**へと不可逆的にシフトしているからです。
街中を走り回る数百万台の自動運転車、工場や家庭で稼働する数億台の人型ロボット、そして都市全体の送電網やサプライチェーン。 これら現実世界に存在する無数のエッジデバイスが、カメラやLiDARで捉えた「物理世界の動向」をリアルタイムにデータセンターへ送り届けます。
データセンターという巨大な頭脳は、その入力をもとに「仮想の地球(デジタルトランスフォーメーション/物理シミュレーション空間)」をミリ秒単位で更新し、最適解を計算して、再び現実世界のロボットたちの手足へとフィードバックします。
これを支えるためには、もはや「時々止まるクラウド」や「のろまな銅線」は許されません。 心臓の鼓動のように1秒の狂いもなく動き続ける電力インフラと、光速でシグナルを伝達する神経網が不可欠です。
結論:ボトルネックの破壊史が創り出す「人類の新たな知能基盤」
全10話にわたって私たちが目撃してきたのは、単なるハイテク企業のシェア争いではありませんでした。
- 1万人の単純労働部隊を従えたNVIDIAのGPUとCUDA帝国(第1話)
- データをマンションのように積み上げたHBMとTSVの立体配線(第2話)
- GPUを飢餓から救うCPUと超高速NVMeストレージの兵站戦(第3話)
- 界面の矛盾をねじ伏せた味の素ABFと日本のケミカル(第4話)
- 波長13.5nmの光を操るASMLとレーザーテックの検査技術(第5話)
- モノリシックの死を救ったチップレットとTOWAのモールディング(第6話)
- 電子を捨てて宇宙最速の乗り物へ移行した光電融合CPO(第7話)
- 熱力学の鉄則に挑む液冷技術とVertiv・変電インフラ(第8話)
- 手元で巨大モデルを操るユニファイドメモリの空間統合(第9話)
そして第10話、これらすべてのボトルネック破壊の結晶として、コンピュータは「机の上の箱」を完全に脱ぎ捨て、**「地球の送電網と光ファイバー網に直結した、惑星規模のエネルギー・知能変換装置」**へと昇華しました。
計算の速さとは、演算器の速さではない。 「熱」「電力」「ナノの素材」「データの移動」という、この宇宙を支配する物理法則との果てしない対話の積み重ねこそが、テクノロジーの歴史そのものです。
物理の限界に衝突するたび、人類はそれを迂回し、打ち破り、新たな地平を切り拓いてきました。 データセンターという巨大な知能の胎動は、まだ始まったばかりです。
📝 3行で頭に入る『試験・実務・投資の要点まとめ』
- 【ノイマンの終焉】 データの移動損失をゼロにするため、メモリ素子内で物理法則(オームの法則等)により直接行列計算を行う「インメモリ計算」や「光演算」が実用化へ向かう。
- 【スケールの超越】 露光枠を超えて300mmウエハ丸ごとを1チップ化するウエハスケール(Cerebras)や、液冷・CPOでラック全体を1つのシリコンと見なすデータセンタースケールへ進化。
- 【フィジカルAIの母体】 コンピュータの最終形は「箱」ではなく、ギガワットの送電網と光網でナノ秒同期された巨大データセンター群。現実世界のロボットや都市を統括する惑星規模の頭脳となる。