データ圧縮のアルゴリズム 〜なぜ中身を壊さずにサイズを半分にできるのか?〜
1. 素朴な疑問:「データを縮めて元に戻す」ってどんな手品なの?
重たいファイルをメールで送るとき、右クリックして「ZIPファイルに圧縮」を押すと、容量が10MBから5MBへと一瞬で半分に縮みます。 そして相手が「解凍(展開)」すると、1文字の狂いもなく元のWordやExcelファイルが復活します。
これを見て、不思議に思ったことはないでしょうか?
「スポンジなら水や空気を抜いて縮めるイメージが湧く。でも、コンピュータの中にあるのは第4話で学んだ『0と1の数字』だけのはず。数字をどうやって『ギューッ』と縮めて、どうやって元通りに戻しているの? 魔法なの?」
さらに不思議なのが、写真(JPEG)や音楽(MP3)です。 CDの楽曲データをMP3に変換すると、ファイルサイズは「10分の1」に激減します。90%ものデータがゴミ箱に捨てられた計算です。 それなのに、イヤホンで聴いてみても、私たちの耳にはCDとほとんど違いが分かりません。
なぜ、中身を1文字も壊さずに半分にできるのでしょうか? そしてなぜ、9割ものデータを捨てているのに人間にはバレないのでしょうか? そこには、**「数学のパズル」と「人間の五感の錯覚」**を悪用した、エンジニアたちの凄まじい知恵が詰まっています。
2. 概念の芯:「絶対に1文字も失えない世界」vs「バレなきゃOKの世界」
データ圧縮の世界には、大きく分けて**2つの流派(世界観)**が存在します。
- 可逆圧縮(Lossless Compression / ロスレス):解凍したとき、1ビットの狂いもなく100%完全に元通りになる圧縮。
- 主な用途:プログラム(
.exe)、文章(.docx)、ZIPファイル、PNG画像
- 主な用途:プログラム(
- 非可逆圧縮(Lossy Compression / ロッシー):元通りには戻せないが、「人間の目や耳にはバレない無駄なデータ」を豪快に削ぎ落とす圧縮。
- 主な用途:デジカメの写真(JPEG)、YouTubeの動画(MP4)、ストリーミング音楽(MP3/AAC)
プログラムや契約書のテキストは、1文字でも欠けたらプログラムが暴走したり法律トラブルになったりします(即死)。だから、**絶対に元の形に戻せる「可逆圧縮」**を使います。
一方、写真や音楽は「人間が楽しむためのもの」です。 人間の目や耳には生物学的な限界があり、すべての光や音を知覚できるわけではありません。 「どうせ人間には聴こえない・見えないなら、最初から捨ててしまえ!」と割り切ることで、圧倒的なサイズダウンを実現するのが**「非可逆圧縮」**です。
3. 本題:可逆圧縮の奥義「ハフマン符号化」とモールス信号
まずは、1文字も壊さずに縮める「可逆圧縮」の仕組みから暴きましょう。 一番単純な発想は、同じ文字の繰り返しを数える**「ランレングス圧縮(連長圧縮)」**です。
AAAAABBBCCCCCC(14文字) ➡️A5B3C6(6文字に圧縮!)
白黒のファックスのように「白いマスが100個、黒いマスが5個…」と続くデータなら、これだけで劇的に縮みます。
触って試す:ランレングス圧縮の体験
🗜️ ランレングス圧縮の体験
文字列を選ぶと、同じ文字の繰り返しを「文字×個数」に置き換えるランレングス圧縮(連長圧縮)を、その場で実際に計算します。繰り返しが多いデータほど劇的に縮むことを確かめてください。
そこで登場したのが、現代のZIPファイルの心臓部で使われている大発明**「ハフマン符号化(Huffman Coding)」**です。
モールス信号の天才的なひらめき
1952年、マサチューセッツ工科大学(MIT)の大学院生デビッド・ハフマンは、歴史ある**「モールス信号」**から最高のヒントを得ました。
モールス信号では、英語で最も頻繁に出てくる文字「E」には、一番短くて打ちやすい**「トン(・)」という1文字の信号を割り当てています。 逆に、滅多に出てこない「Q」には「ツーツートントン(ーー・・)」**という長い信号を割り当てています。
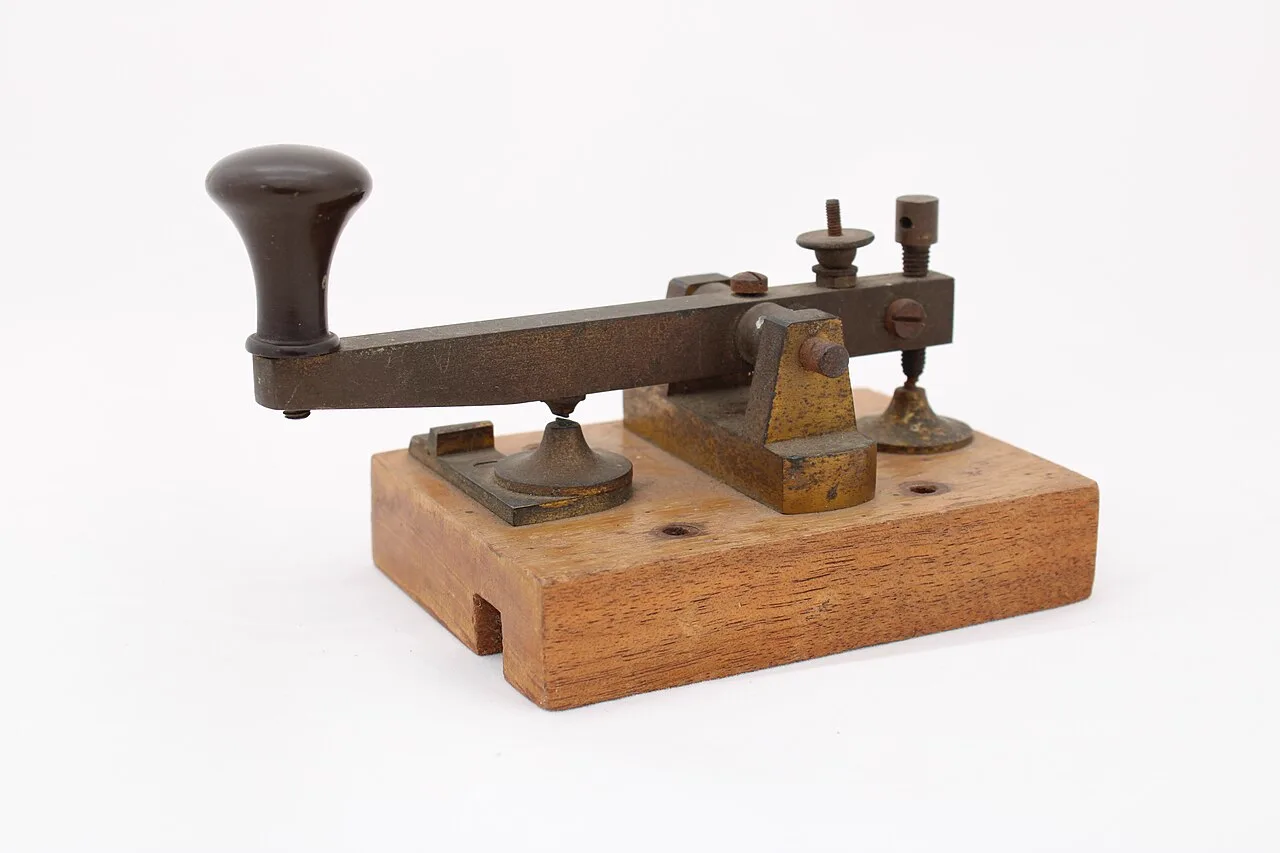

第20話で学んだとおり、普通のコンピュータ(ASCIIなど)は、どんな文字にも「8ビット(1バイト)」という同じ長さの出席番号を与えていました。 ハフマンはこう考えました。
「文章の中で『登場回数が多い文字』には短いビットを割り当て、『滅多に出てこない文字』には長いビットを割り当てれば、文章全体の総ビット数は圧倒的に少なくなるはずだ!」
どうやって混ざらないように区切るのか?(ハフマン木)
ビットの長さが文字によってバラバラだと、「どこからどこまでが1文字か」が分からなくなりそうですよね。 これを完璧に防ぐのが、二分木(トーナメント表のような樹形図)を使った**「ハフマン木」**という数学パズルです。
ハフマン木で作った暗号表は、**「どの文字の暗号も、別の文字の暗号の先頭部分と決して被らない(接頭辞フリー)」**という美しい性質を持ちます。 そのため、カンマやスペースなどの区切り文字を一切挟まなくても、左から数字を読んでいくだけで、誰でも1通りに完璧に元の文章へと復元できるのです。
4. 割り切りの美学:人間の耳と目のサボりを突く「MP3とJPEG」
次に、写真や音楽を10分の1に縮める「非逆圧縮」の悪魔的な手品を見てみましょう。 非可逆圧縮は、数学の技術というより**「生物学(人間の錯覚)をハックする技術」**です。
① 音楽(MP3):人間の耳は「大きな音の直後の小音」が聞こえない
音楽CDの生データ(WAV)は、1秒間に44,100回も空気の振動を記録した巨大なファイルです。 これをMP3に圧縮するとき、プログラムは何をしているのでしょうか?
人間の耳(脳)には、**「聴覚心理学」**と呼ばれる不思議なクセ(弱点)があります。
MP3の開発者たちは、「どうせ人間の耳には物理的に認識できない音データ」を徹底的にリストアップし、波形データからごっそりと消去しました。 データはスカスカに削られていますが、人間が聴く分には「まるで全部の音が鳴っている」ように錯覚します。人間の脳の処理落ちを利用して、容量だけを10分の1にダイエットしたのです。
② 写真(JPEG):人間の目は「色」よりも「明るさ」に圧倒的に敏感
スマホのカメラで撮った写真が数メガバイトで済んでいるのも、**「JPEG(ジェイペグ)」**という非可逆圧縮のおかげです。
人間の網膜には、明暗を感じる細胞(桿体)が約1億個あるのに対し、色を感じる細胞(錐体)は600万個しかありません。 つまり、人間は「輪郭や明るさ(輝度)」の変化には極めて敏感ですが、「色の鮮やかさ(色差)」の微妙な変化には恐ろしいほど鈍感なのです。
JPEGは、第5話で学んだ「RGB(光の三原色)」を、**「Y(明るさ)」と「Cb/Cr(色合い)」**に分解します。 そして、明暗のデータは細かく残しつつ、色のデータだけを隣のピクセルと強引に合体させて半分以下に間引いてしまいます。 さらに、滑らかなグラデーションの細かな波(高周波成分)を丸めて捨てる(離散コサイン変換と量子化)ことで、人間の目には高画質に見えるまま、ファイルサイズを劇的に縮めているのです。
5. 物理の壁:なぜ「ZIPをもう一度ZIP」しても小さくならないのか?
パソコンを触り始めた人が、誰しも一度は試す実験があります。
「10MBのファイルをZIPで圧縮して5MBになったぞ! じゃあ、この5MBのZIPファイルを『もう一度ZIPで圧縮』したら、2.5MBになるんじゃないか!?」
結果はどうなるでしょうか? 実際にやってみると、2.5MBになるどころか、サイズが1バイトも減らないか、下手をすると圧縮用ヘッダーの分だけ数バイト「太って大きく」なってしまいます。 なぜでしょうか?
この疑問に数学的な終止符を打ったのが、「情報理論の父」と呼ばれるクロード・シャノンが1948年に提唱した**「シャノンの情報源符号化定理(エントロピーの限界)」**です。
データが圧縮できるのは、元のデータの中に**「偏り(同じパターンの重複や無駄)」**が存在するからです。 一度しっかりと圧縮されたZIPファイルの中身は、0と1の出現確率が完全に均等になり、数学的には「完全にランダムな砂嵐(ホワイトノイズ)」と同じ状態になっています。
無駄が1ミリも残っていない「極限まで乾いた雑巾」をいくら力いっぱい絞っても、水は1滴も垂れません。 データ圧縮とは、魔法の小人による縮小ではなく、**「データの中に潜む無駄(エントロピーの偏り)を数学的に平らにならす作業」**に過ぎないのです。
📝 3行で頭に入る「試験・実務の要点まとめ」
- 可逆圧縮と非可逆圧縮:完全に元のデータを復元できる方式を可逆圧縮(ZIP、PNG、GIFなど)と呼び、人間の知覚限界(聴覚・視覚のマスキング効果)を利用して不可視な情報を破棄する方式を非可逆圧縮(JPEG、MP3、MPEGなど)と呼ぶ。
- ハフマン符号化のアルゴリズム:出現頻度の高い文字には短いビット列を、低い文字には長いビット列を割り当てる可変長符号化方式。出現頻度順にノードを結合してハフマン木を構築することで、接頭辞を持たない一意復元可能な符号を生成する。
- シャノンの情報源符号化定理:データが持つ平均情報量(エントロピー)を下回る長さには、いかなる可逆圧縮アルゴリズムを用いても圧縮できないという物理的限界を示す理論。