クラウドと分散システム 〜誰かのパソコンを借りる技術と、CAP定理の究極の二者択一〜
1. 素朴な疑問:「クラウド」って、空の上にデータがあるの?
「写真やファイルをクラウドに保存しました」 「うちの会社の社内システムをすべてクラウドへ移行しました」
ビジネスでも日常でも、「クラウド(Cloud=雲)」という言葉を聞かない日はありません。 アイコンも決まってフワフワとした「空に浮かぶ雲」の形をしています。 そのため、多くの人がなんとなくこうイメージしています。 「インターネットの空の上の、どこか抽象的なデジタル空間にデータが浮かんでいるんだろう」
しかし、有名なITの格言にこんな言葉があります。
「クラウドなんてものは存在しない。そこにあるのは『ただの他人のパソコン』だ(There is no cloud, it’s just someone else’s computer.)」
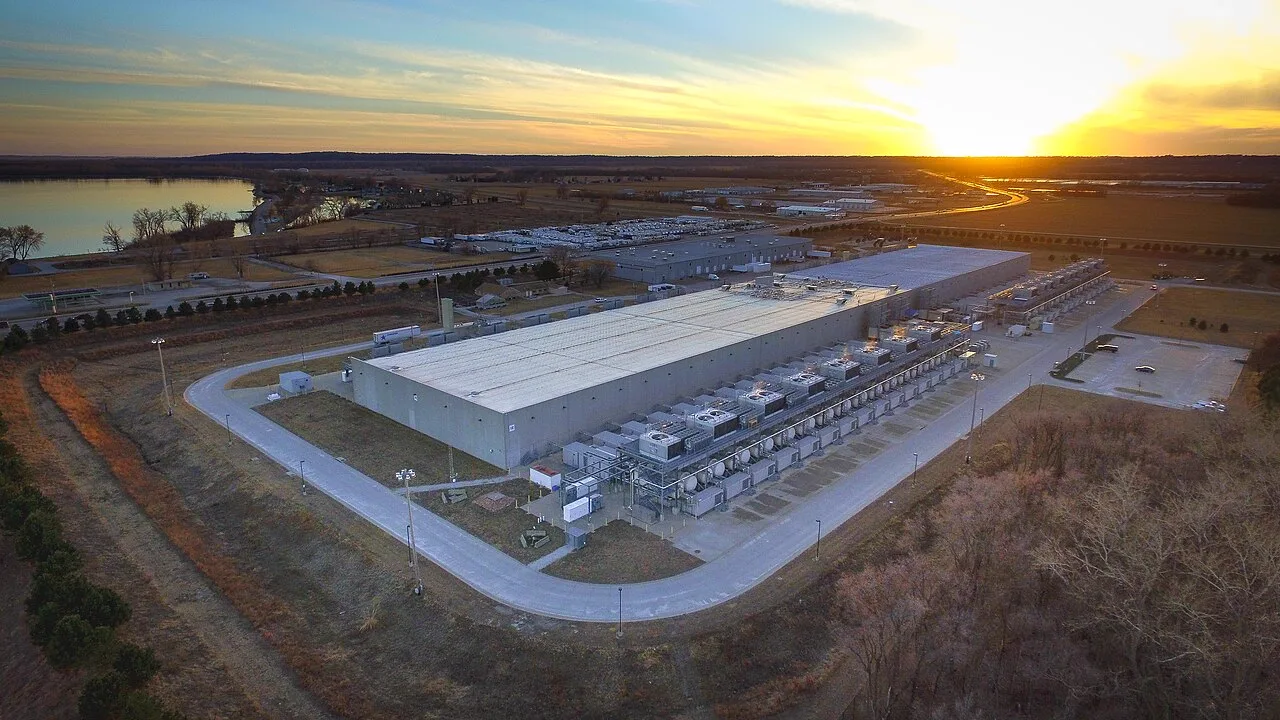
空の上に特別な魔法の空間があるわけではありません。 第1話から学んできた「CPU」「メモリ」「ストレージ」がびっしりと詰まった本物のコンピュータが、アメリカの砂漠や、日本の北海道の巨大な倉庫(データセンター)の中で、冷房の風を浴びながら何万台も唸りを上げて並んでいるだけです。

では、なぜ世界中の企業は、自分たちでパソコンを買うのをやめて、この「他人のパソコン(クラウド)」を競うように借りているのでしょうか? そして、何千台ものパソコンを束ねて1つの巨大な頭脳に見せかけるとき、**避けては通れない「物理の限界(CAP定理)」**とは何なのでしょうか?
2. 概念の芯:1台のスーパーマシン(神)より、1万台の凡人(群衆)
インターネットが爆発的に普及する前、企業が「システムを強化してアクセス集中に耐えよう」としたとき、選べる道は1つしかありませんでした。 それが**「スケールアップ(垂直統合)」**です。
スケールアップの限界:1台の怪物は高すぎて溶ける
「サーバーが重いなら、1台のパソコンの中に世界最強のCPUを挿し、超特大のメモリを積めばいい!」 これは分かりやすい力技です。 しかし、第2話で学んだ「熱の壁」を思い出してください。1台のマシンの性能を上げようとすると、部品の値段は10倍、100倍と跳ね上がり、最後には「これ以上速いパーツが地球上に存在しない」という物理の壁に激突します。 しかも、その高価な1台が落雷や故障で止まった瞬間、会社の全サービスが一瞬で息絶えてしまいます。
スケールアウトの勝利:普通の安物PCを1万台並べろ!
2000年代初頭、GoogleやAmazonの技術者たちは、まったく逆の発想に舵を切りました。それが**「スケールアウト(水平分散)」**です。
「何千万円もする特注のスーパーコンピュータを1台買うのはやめよう! 家電量販店で売っているような『数万円の安物パソコン』を1万台並べて、電線(ネットワーク)で繋げばいい。1台が故障して火を噴いても、ゴミ箱に捨てて新しい安物と取り替えれば、システム全体は1秒も止まらずに動き続けられるじゃないか!」
この「普通のパソコンを何万台も並べて、ソフトウェアの力で1つの巨大な仮想マシンに見せかける技術」。 これが、現代の**「クラウド(AWS、Google Cloud、Microsoft Azure)」の真の正体**です。
3. 本題:交通整理の達人「ロードバランサー」の綱渡り
何千台ものパソコンを並べただけでは、仕事になりません。 世界中からやってくる何億人ものユーザーからのアクセスを、誰かが交通整理して各パソコンに均等に配らなければならないからです。
この交通整理を一手に引き受けるのが、**「ロードバランサー(負荷分散装置)」**です。
ロードバランサーは、裏に並んでいる何百台ものサーバーに向けて、数ミリ秒ごとに「おい、生きてるか?(ヘルスチェック / 死活監視)」と声をかけ続けています。 もし1台のパソコンが煙を吹いて倒れても、ロードバランサーが瞬時に気配を察知し、「よし、あいつにはもう客を回すな!」とルートから切り離します。
私たちがTwitterやYouTubeを使っていて、裏でサーバーが毎日何十台も壊れているのにまったく気づかずに済んでいるのは、このロードバランサーが0.001秒の反射神経で交通整理を続けているおかげなのです。
触って試す:分散と冗長化の体験
🌐 分散と冗長化の体験(ロードバランサーの振り分け)
構成を選んで「リクエストを送る」を押すと、ロードバランサーが稼働中のサーバーへ順番に振り分けます。「💥 1台落とす」でサーバーの故障を再現できます。1台構成と3台構成で、故障したときの結末を比べてみてください。
まずは「リクエストを送る」を押してみてください。
4. 物理の壁:分散システムを縛る悪魔の法則「CAP定理」
ここからが、コンピュータ科学における最も美しく、最も残酷なハイライトです。
「パソコンを何台でも並べてスケールアウトできるなら、コンピュータの性能は無限に上げられるじゃないか!」と思いますよね。 しかし、1台のパソコン(集中型)から、複数台のパソコン(分散システム)に移行した瞬間、光の速度という物理法則が牙を剥きます。
それが、カリフォルニア大学のエリック・ブリュワーズ教授が提唱した、分散システムの絶対法則**「CAP(キャップ)定理」**です。
【CAP定理の鉄則】 ネットワークで繋がれた分散システムにおいて、以下の3つの性質のうち、「同時に2つ」までしか絶対に手に入れることはできない(どれか1つを必ず諦めなければならない)。
- C(Consistency / 一貫性):どこから読んでも、全員が「完全に同じ最新データ」が見える。
- A(Availability / 可用性):何台かが壊れても、必ず「エラーを出さずに返事」を返す。
- P(Partition Tolerance / 分断耐性):電線が切れてマシン同士の通信が途絶えても、システムが動く。
なぜ同時に3つを手に入れられないのか?(新幹線の座席予約の悲劇)
東京のサーバー(A)と、大阪のサーバー(B)の2台で、新幹線の座席予約システムを動かしているとしましょう。 座席「1号車A席」は、残り1席しかありません。
ここで、**「東京と大阪を結ぶ光ファイバーが、工事のショベルカーに切断された(ネットワーク分断:Pの発生)」**とします。 お互いに電話もネットも通じません。
その瞬間に、東京の客が「1号車A席を予約したい!」とボタンを押し、まったく同時に大阪の客も「1号車A席を予約したい!」とボタンを押しました。
システム管理者は、どちらか1つの「地獄」を選ばなければなりません。
- 道①:一貫性を取る(CPシステム) 「大阪の予約状況が確認できない以上、怖くて予約を受け付けられない! お客さんには『通信エラーです』とエラー画面を出してシステムを止めよう(可用性を捨てる)」。 ➡️ 銀行や新幹線の予約システムの選択です。二重引き落としや二重予約を防ぐため、安全第一でシステムを停止させます。
- 道②:可用性を取る(APシステム) 「エラー画面を出して客を逃すのは絶対に嫌だ! とりあえず両方に『予約完了』と返事を出しておこう(一貫性を捨てる)」。 ➡️ Twitterの「いいね」やYouTubeの再生回数の選択です。東京と大阪で表示される「いいね数」が数分間ズレていても誰も死にません。「あとで電線が繋がったときに、つじつまを合わせればいいや(結果整合性)」と割り切ります。
どんなにテクノロジーが進化しても、東京から大阪へ電気信号が届くには数ミリ秒の時間がかかります。 「光の速度が有限である以上、世界中のコンピュータが寸分の狂いもなく同時に同じデータを持つことはできない」。CAP定理とは、宇宙の物理法則がコンピュータに突きつけた冷酷な境界線なのです。
5. グランドフィナーレ:24の部品が織りなす「1つの奇跡」
ここまで全24話、『コンピューティングの芯』を走り抜けてきました。
第1話で「メモリとストレージ」の違いから始まった私たちの旅は、今や地球規模の「クラウドと分散システム」にまで到達しました。 あなたがスマホで何気なく画面をタップし、メッセージを送信したその一瞬(0.1秒)に、今日まで学んできた24個の技術が、ドミノ倒しのように完璧なリレーを行っています。
日常の当たり前を支えているのは、魔法ではありません。 電気のノイズに怯え、熱の壁に阻まれ、記憶喪失に悩み、通信の衝突に苦しみながら、何万人もの先人たちが「物理法則とコストの限界」に対して泥臭く積み上げてきた、驚くほど合理的で人間味あふれる工夫の結晶です。
コンピュータの「芯」を手に入れたあなたには、もうITのブラックボックスは怖くありません。 画面の向こう側で蠢く0と1のドラマが、手にとるように見えるはずです。
📝 3行で頭に入る「試験・実務の要点まとめ」
- クラウドのサービスモデル:インフラ基盤(仮想マシン・ネットワーク)を提供するIaaS、アプリ実行環境(OS・DB・ミドルウェア)を提供するPaaS、完成したソフトウェアを提供するSaaSに分類される。
- スケールアップとスケールアウト:単一サーバーのCPU・メモリ増強による性能向上(スケールアップ)に対し、複数サーバーの並列追加とロードバランサーによる負荷分散で処理能力を高める手法をスケールアウトと呼ぶ。
- CAP定理と結果整合性:分散システムではConsistency(一貫性)、Availability(可用性)、**Partition Tolerance(分断耐性)の3つを同時には満たせない。厳密な即時一貫性を妥協し、最終的にデータが一致すればよいとする設計思想を結果整合性(Eventual Consistency)**と呼ぶ。