GPUと超並列アーキテクチャ(CUDAとテンソルコア)――なぜAIはNVIDIA一強なのか? 画面を描くチップが世界の頭脳になるまで
1. 素朴な疑問:ゲームの絵を描くパーツが、なぜ最新AIの頭脳になったのか?
「ChatGPTのような最先端AIを動かしているのは、なぜIntelの高性能CPUではなく、NVIDIAのGPUなのか?」 「もともとPCゲームで綺麗な3Dグラフィックを描くためのパーツだったはずなのに、なぜ1枚数百万円で世界中のテック企業が奪い合っているのか?」
コンピュータの歴史を振り返っても、これほど劇的で奇妙な転身を遂げたハードウェアはありません。
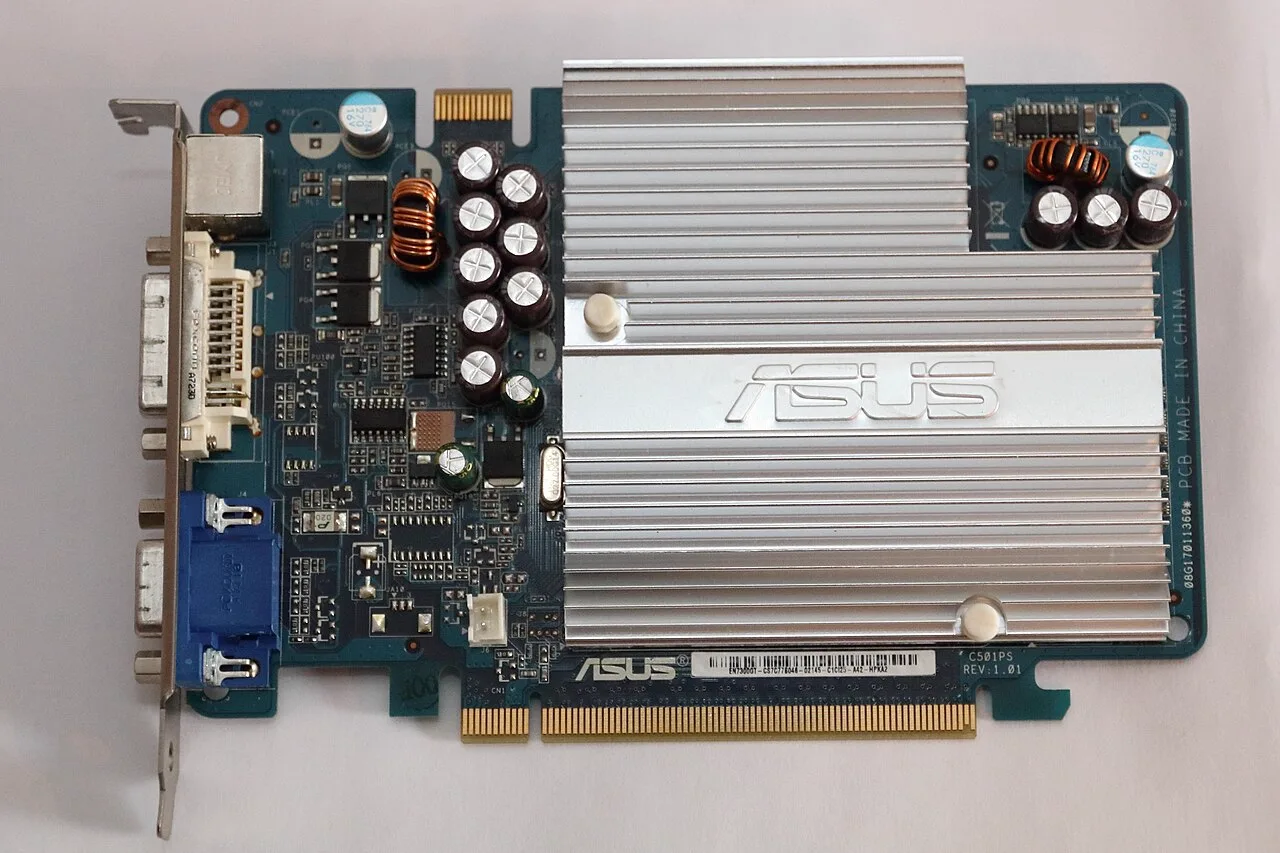
長年、PCやサーバーの中心は常にCPU(中央演算処理装置)でした。GPU(グラフィックス演算処理装置)は、ディスプレイに高精細な映像を映し出すための、いわば「裏方の画像描画カード」に過ぎなかったのです。
しかし現在、世界のAI開発の現場では、NVIDIAのデータセンター向けGPU(H100やB200など)が絶対的な覇権を握っています。
なぜグラフィックボードがAIの頭脳になれたのか? その理由は極めて明快です。「3Dゲームの画面を計算すること」と「ディープラーニング(深層学習)を計算すること」が、数学的に全く同じ「巨大な行列の掛け算と足し算(行列積)」だったからです。
2. 思想の決定的な違い:少数の「大天才」か、数万人の「小学生」か
CPUとGPUは、同じシリコン半導体でありながら、目指している哲学が180度正反対です。
- CPU:少数の「超大天才」 コア数はせいぜい数個〜数十個。しかし、1つのコアが極めて賢く、クロック周波数は5GHzを超え、巨大なキャッシュメモリと高度な分岐予測回路を持ちます。「複雑で先が読めない1本のプログラムを、極限まで低い遅延(レイテンシ)で終わらせる」ために最適化されています。
- GPU:数万人もの「小学生」 コア数は数千〜数万個。1つひとつのコアは非常に単純で、難しい分岐予測もできず、クロックも1〜2GHz程度しかありません。しかし、「全員に同じ単純な計算ドリルを一斉に配り、1秒間に兆単位の力づくで解かせる(スループットの最大化)」ことに特化しています。
3D画面を描く物理:4Kディスプレイの画素数は830万個
なぜGPUはこのような構造になったのでしょうか。 4K解像度($3840 \times 2160$)のディスプレイには、約830万個のピクセル(画素)が並んでいます。秒間60フレームでゲームを動かすには、わずか0.016秒(16ミリ秒)の間に、830万個すべてのピクセルの色、光の反射、影の濃さを計算し終えなければなりません。
超大天才のCPUに「1番目のピクセルから順に計算してください」と頼んだら、いくら天才でも830万回繰り返すうちに制限時間が過ぎて画面がカクつきます。
それよりも、「四則演算しかできない小学生を830万人集めて、全員同時に1人1ピクセル塗らせる」ほうが圧倒的に速い。これがGPUの並列思想です。
そして、近年のディープラーニングで扱う数千億パラメータの言語モデルも、本質は**「何千億個もの重み(パラメータ)に対して、同じパターンの掛け算と足し算を何兆回も叩き込む」**処理です。CPUの天才的な頭脳は一切不要で、GPUの「数万人の力づく」こそが、AIにとって最も渇望していた計算パワーだったのです。
触って試す:逐次処理 vs 並列処理レース
🏁 逐次 vs 並列レース(32個の計算タスク)
「スタート」を押すと、32個のピクセル計算を2つの方式で同時に処理します。CPU方式は「天才4人」が1クロックに4個ずつ順番に解き、GPU方式は「小学生32人」が一斉に解きます(ただしGPUの1クロック自体はCPUより長めです)。
CPU方式(4コア × 8クロック)
待機中
GPU方式(32コア × 1クロック ※1クロックは長め)
待機中
1つ1つの速さ(レイテンシ)ではCPUの勝ち。でも「全員の合計」(スループット)ではGPUが圧勝します。スタートを押してみてください。
3. 数万コアを統率する物理:SIMT方式と「ワープ」の掟
「いくら単純な計算とはいえ、数万個ものコアがバラバラに動いたら、命令を出すだけでパンクするのでは?」
その通りです。そこでNVIDIAが開発したのが、**「SIMT(Single Instruction, Multiple Threads:単一命令・複数スレッド)」**というアーキテクチャです。
GPUは、スレッドを1本ずつバラバラに実行しません。「32本のスレッド」をひとかたまりの結束バンドで束ねて扱います。この最小単位を「ワープ(Warp)」と呼びます。
命令を出す司令塔(デコーダやスケジューラ)は1つで済みます。「全員、配列の自分の担当箇所を掛け算しろ!」と1回叫ぶだけで、32個のコアが寸分違わず同時に動くため、制御回路の面積を極限まで小さくし、シリコンのほぼ全面を「計算機(ALU)」で埋め尽くすことができるのです。
並列プログラマーを泣かせる「分岐ダイバージェンス」
しかし、このSIMT方式には過酷な物理的弱点があります。それが**「ワープ・ダイバージェンス(Warp Divergence:条件分岐による分裂)」**です。
もしプログラムの中に if (条件) { Aの処理 } else { Bの処理 } という分岐があったとします。
32本のスレッドのうち、16本が条件を満たし、残り16本が満たさなかった場合、GPUはどうするでしょうか?
【分岐ダイバージェンスの悲劇】
1. まず前半16スレッドが「Aの処理」を実行する。
   (この間、後半16スレッドは何もせず指をくわえて待つ:実行効率50%)
2. 次に後半16スレッドが「Bの処理」を実行する。
   (この間、前半16スレッドは何もせず指をくわえて待つ:実行効率50%)
全員で同じ命令を一斉に行進するのがワープの掟であるため、道が2つに分かれると「片方を待たせて、順番に両方の道を歩く」しかありません。複雑な条件分岐が重なると、GPUの性能はあっという間に地に落ちます。
AIの計算がGPUにこれほど適合したのは、ニューラルネットワークの計算に行列の掛け算ばかりが延々と続き、**「ややこしいif文がほとんど存在しない」**という奇跡的な相性の良さがあったからなのです。
4. 精度を捨てて速度を買う:テンソルコアと低精度(FP16/FP8)の幾何学
従来の科学技術計算(天気予報、流体力学、ロケットの弾道計算など)では、小数点以下15桁まで正確に計算する「64ビット倍精度浮動小数点(FP64)」が絶対的正義でした。1ミリの計算狂いがロケットの爆発に繋がるからです。
しかし、2010年代半ば、AI研究者たちは直感に反する大発見をします。
「画像認識や言語モデルのニューラルネットワークは、計算精度を極限まで落としても、認識の正解率がほとんど下がらない」
AIがやっているのは「猫か犬か」「次の単語は『リンゴ』か『バナナ』か」という確率的な推論です。途中の計算が「0.85239148…」であろうが、大雑把に丸めて「0.85」であろうが、最終的な結論は何も変わりません。
16ビットから8ビットへ:半分にすれば4倍速くなる物理
データのビット幅を半分(32bit $\to$ 16bit)にすると、何が起きるでしょうか。
- メモリ転送量が半分になる: 前話で解説した「メモリの壁」が一気に緩和され、同じメモリ帯域で2倍のデータをチップに流し込める。
- 掛け算回路(乗算器)の面積が4分の1になる: 2進数の掛け算器の回路規模は、ビット数の「2乗」に比例して小さくなります。
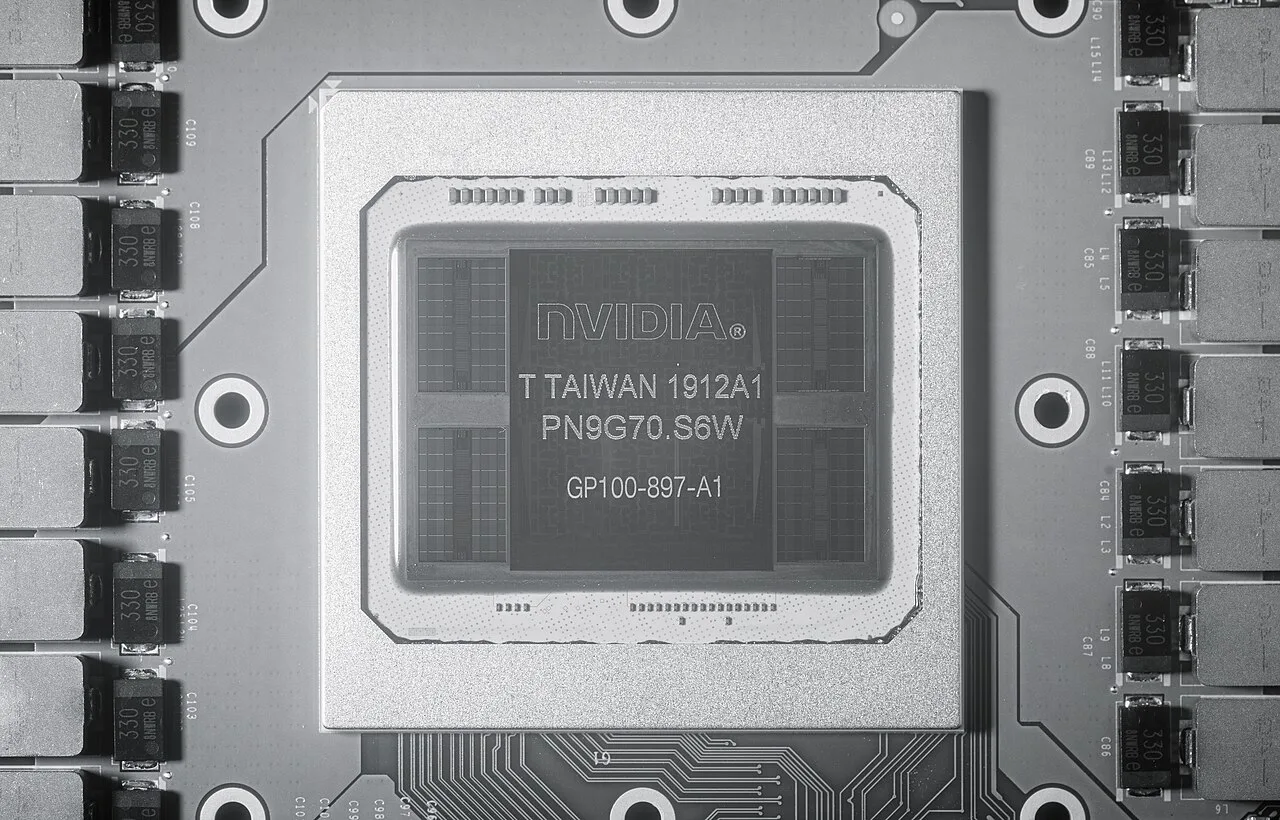
NVIDIAはこの数学的割り切りを世界最速でハードウェア化しました。それが2017年のVoltaアーキテクチャから搭載された**「テンソルコア(Tensor Core)」**です。
【テンソルコアの基本演算】
D = A × B + C
(A, B, C, D は 4×4 や 16×16 の極小行列)
通常のGPUコアが「1クロックに1回の足し算や掛け算」を行うのに対し、テンソルコアは**「行列と行列の掛け算+足し算(積和演算)」を、ハードウェアの配線そのものとして1クロックで一撃で実行**します。
さらに最新のBlackwellアーキテクチャでは、「FP4(わずか4ビットの浮動小数点)」まで精度を落として計算する専用回路を搭載しました。精度を大胆に捨て去ることで、同じ電力、同じシリコン面積から、従来の数百倍もの実効AI計算能力を絞り出すことに成功したのです。
5. なぜ他社は勝てないのか?――「CUDA」という15年掘り続けた堀(Moat)
「ハードウェアの仕組みが分かっているなら、IntelやAMD、あるいはGoogleやAmazonが自社チップを作れば、すぐにNVIDIAを倒せるのではないか?」
誰もがそう考えます。実際、AMDのGPU(Instinctシリーズ)やGoogleのTPUなど、カタログスペック上の計算力やメモリ容量でNVIDIAに匹敵、あるいは上回るチップは存在します。
それでもなお、世界のAI企業がNVIDIAに札束を積み続ける理由。 それはチップの性能ではなく、**「CUDA(クーダ)」というソフトウェアの巨大な堀(Moat)**にあります。
2006年の狂気:全GeForceに赤字覚悟でCUDAを載せたジェンスン・フアン
CUDAとは、2006年にNVIDIAが発表した**「C/C++などの一般的なプログラミング言語で、GPUの並列計算を直接プログラミングできるようにする開発環境」**です。
当時、GPUを計算に使うには、汎用データを無理やり「3Dポリゴンの頂点座標」や「テクスチャ画像」の形式に偽装してグラフィックパイプラインに流し込むという、曲芸のようなプログラミングが必要でした。
NVIDIAの創業者兼CEOのジェンスン・フアンは、まだAIの影も形もなかった2006年、途方もない賭けに出ます。 **「今後出荷するすべての家庭用ゲーム向けGeForceチップに、回路面積を食い、製造原価を跳ね上げるCUDA専用回路を標準搭載する」**と決断したのです。
ウォール街のアナリストたちは「ゲームに関係ない無駄な回路で利益率を下げる狂気の沙汰」と猛烈に批判し、NVIDIAの株価は暴落しました。しかしこの決断によって、世界中の大学の研究者や学生たちが、手元の安価なゲーミングPCを使ってGPU並列プログラミングを研究できる環境が整いました。
2012年、世界を驚愕させた画像認識AI「AlexNet」が登場したとき、その開発者たちが使ったのも、研究室のPCに刺さっていた市販のNVIDIA GeForceでした。
15年の筋肉記憶とカーネルチューニング
今日、PyTorchなどの主要なAIフレームワークのコードを開くと、その深層はNVIDIAのGPUに極限まで最適化された数千本もの手書きアセンブラ・C++コード(cuDNNやcuBLAS)で埋め尽くされています。
他社がどんなに優れたハードウェアを作っても、
- 「ライブラリが対応していない」
- 「動かそうとすると謎のエラーで落ちる」
- 「コミュニティに解決策が落ちていない」 という壁にぶち当たります。
AI研究者にとって最も貴重な資源は「自分の時間」です。他社のチップでバグと格闘して数ヶ月浪費するくらいなら、2倍の値段を払ってでも「コードを書けば明日から確実にフルスピードで動くNVIDIA」を選ぶ。この15年間に積み上げられた全世界のエンジニアの筋肉記憶とソフトウェア資産こそが、誰も崩せないNVIDIA一強の真因なのです。
6. まとめ:GPUとは「極限まで無駄を削ぎ落とした数学工場」である
GPUが切り拓いた世界を総括すると、以下のようになります。
- CPUとの住み分け: 複雑な処理を1本の線で素早く解くCPUに対し、GPUは単純な行列計算を数万本の線で力づくで解く超並列マシンである。
- SIMTの掟: 32個のスレッドを束ねる「ワープ」単位で動くため、複雑な条件分岐は厳禁。全コアが同じ計算を反復するディープラーニングと奇跡的に合致した。
- テンソルコアの幾何学: 正確な数値を求めず、8ビットや4ビットまで精度を切り捨てることで、爆発的なスループットと省電力を獲得した。
- CUDAの絶対防壁: ハードウェアの優秀さだけでなく、15年以上前から研究者コミュニティを囲い込み、最適化を極めたソフトウェア基盤が勝敗を決定づけた。
3Dゲームの映像を滑らかに描くために生まれたアーキテクチャは、いまや人類の新たな知能を創り出すエンジンの心臓部となりました。 私たちが画面の向こうのAIと言葉を交わすその一瞬にも、漆黒のシリコンダイの上では、数万個の極小コアが寸分の狂いもなく隊列を組み、天文学的な数の行列の掛け算を光速で駆け抜けているのです。
📝 3行で頭に入る『試験・実務の要点まとめ』
- CPUとGPUの構造差: CPUは巨大キャッシュと分岐予測で単一タスクの遅延(レイテンシ)を詰めるが、GPUは制御回路を極小化し数万のALUで全体の処理量(スループット)を最大化する。
- SIMTとテンソルコア: 32スレッドを1つの命令で束ねるワープ単位で駆動。テンソルコアはAI特有の低精度(FP16/FP8/FP4)に割り切り、行列積和演算を一撃で解く専用配線を持つ。
- CUDAの堀(Moat): 他社製ハードが追いついても、15年以上かけてPyTorch基盤やcuDNN等の極限最適化ライブラリがNVIDIA専用に深く浸透しているため、エコシステムの乗り換えが極めて困難である。